

大規模言語モデルはどうやって回答を生成するのか?
自動で文章の続きを作る仕組みから大規模言語モデルを理解し、入力が出力に影響する理由を学びます。
最近、「大規模言語モデル」(Large Language Model)という言葉をよく見聞きすると思います。LLM と略されることもあります。多くの人はこれを「人工知能」と呼びますが、それは正しいのでしょうか。実際には何で、なぜ SF 映画の人工知能のように見えるのでしょうか。
1. 全自動で文章の続きを作る仕組み
簡単にたとえると、LLM は全自動で文章の続きを作る仕組みです。例えば、DeepSeek や ChatGPT などの LLM に、次のように質問したとします。
モデルは一連の計算を行います。ただし、想像している仕組みとは違うかもしれません。モデルは「考える」のではなく、さまざまな計算によって、この質問の次に来る確率が最も高い「文字」を予測します。

例えば「今日の広州の天気はどうですか?」に対して、ある生成では、次の文字として「今」が得られるかもしれません。
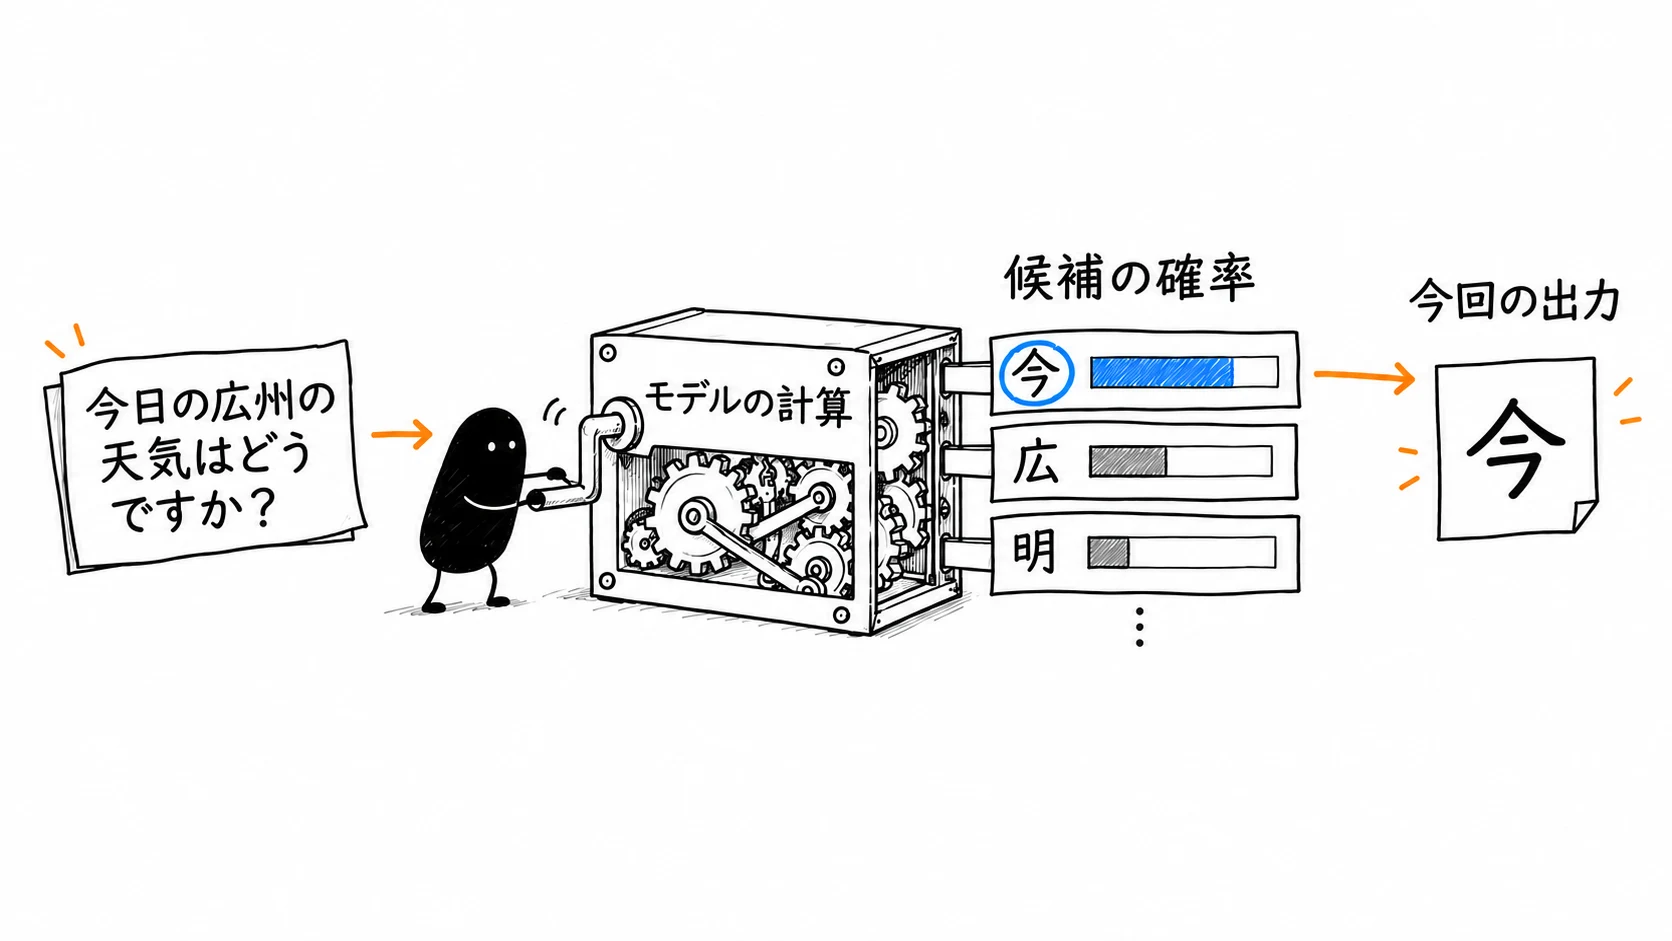
「今」が得られると、モデルは「今日の広州の天気はどうですか?今」を新しい入力として、次の文字をもう一度計算します。次が「日」なら、「今日の広州の天気はどうですか?今日」になります。この処理を繰り返し、最終的な結果を作ります。
全体の流れは、おおよそ次のようになります。
最終的に、製品には次のような回答が表示されます。
この原理が分かると、LLM を使う製品で回答が一文字ずつ表示される理由も理解できると思います。
2. この概念を知ると何に役立つのか?
この簡単な原理が分かると、GPT-3.5 の頃など、LLM 製品の初期にプロンプトエンジニアリングのさまざまな技法が登場した理由も分かるはずです。
例えば翻訳では、英語の原文の前に「あなたは英語と中国語の翻訳に精通した専門家です。次の英文を翻訳してください……」といった指示を追加できます。このような指示、つまりプロンプトを加える目的は、LLM が満足できる回答を出す確率を高めることです。
なぜでしょうか。
AI とやり取りするには、求めることを文章で書く必要があります。関連する概念を知らなければ、要件を明確に伝えることは困難です。つまり、LLM に適切な質問や指示を出しにくくなります。指示が曖昧だったり説明が間違っていたりすれば、回答の質が低くなり、誤った回答になることもあります。
下の 2 つのボタンを、それぞれ押してみてください。同じ項目を持つメニューが表示されますが、見た目は大きく異なります。どちらの操作体験がよいと感じますか。
プログラミングやプロダクトに関する概念を知らなければ、「ボタンを押すと、メニュー A、B、C の 3 つのボタンがあるメニューを表示して」という一文だけに頼るかもしれません。
その場合、モデルは確率的に最もありそうな結果、言い換えると平凡な結果を出す可能性が高くなります。関連する知識があれば、改善のための具体的な指示を LLM に出し、出力をよりよくできます。
このコースで伝えたいのは、そうした知識です。