

モデルはどうやって画像を見て、音を聞くのか
数値表現とエンコーダーからマルチモーダルモデルを理解します。画像理解、文字の読み取り、文字起こし、音声理解を区別し、認識結果の確認を学びます。
ここまでは、テキストを入力するとモデルがテキストを生成する仕組みを説明しました。しかし今では、スクリーンショット、写真、録音をアップロードし、その内容を質問できる AI 製品もあります。
テキストはトークナイザーを通り、モデルが処理できる数値になります。それでは、写真や録音はどうやってモデルに入るのでしょうか。
出発点は同じです。異なる形式の情報を、モデルが計算できる数値表現に変換します。
1. マルチモーダルとは何か
モダリティとは、情報の形式です。テキスト、画像、音声は異なるモダリティです。マルチモーダルモデルは、複数の形式を扱えます。たとえば、画像とテキストを一緒に受け取り、テキストで答えます。
| 製品で使える機能 | 関係する能力 |
|---|---|
| 写真を送り、何が写っているか聞く | 画像入力とテキスト出力 |
| 録音を送り、話の内容を要約する | 音声認識、または音声理解とテキスト出力 |
| 入力した文章を読み上げる | 音声生成 |
| 写真を送り、別の画像を作ってもらう | 画像理解と、画像生成または編集 |
これらを 1 つのモデルが行う場合も、製品内の複数のモデルが協力する場合もあります。たとえば、録音を文字起こしし、そのテキストを言語モデルに渡すことで音声入力を提供できます。
音声入力の機能があるだけでは、内部の言語モデルが音を直接処理できるとは分かりません。
2. モデルはどうやって画像を見るのか
スクリーンショットを送り、「右下のボタンには何と書いてありますか?」と聞くとします。流れは 3 段階です。
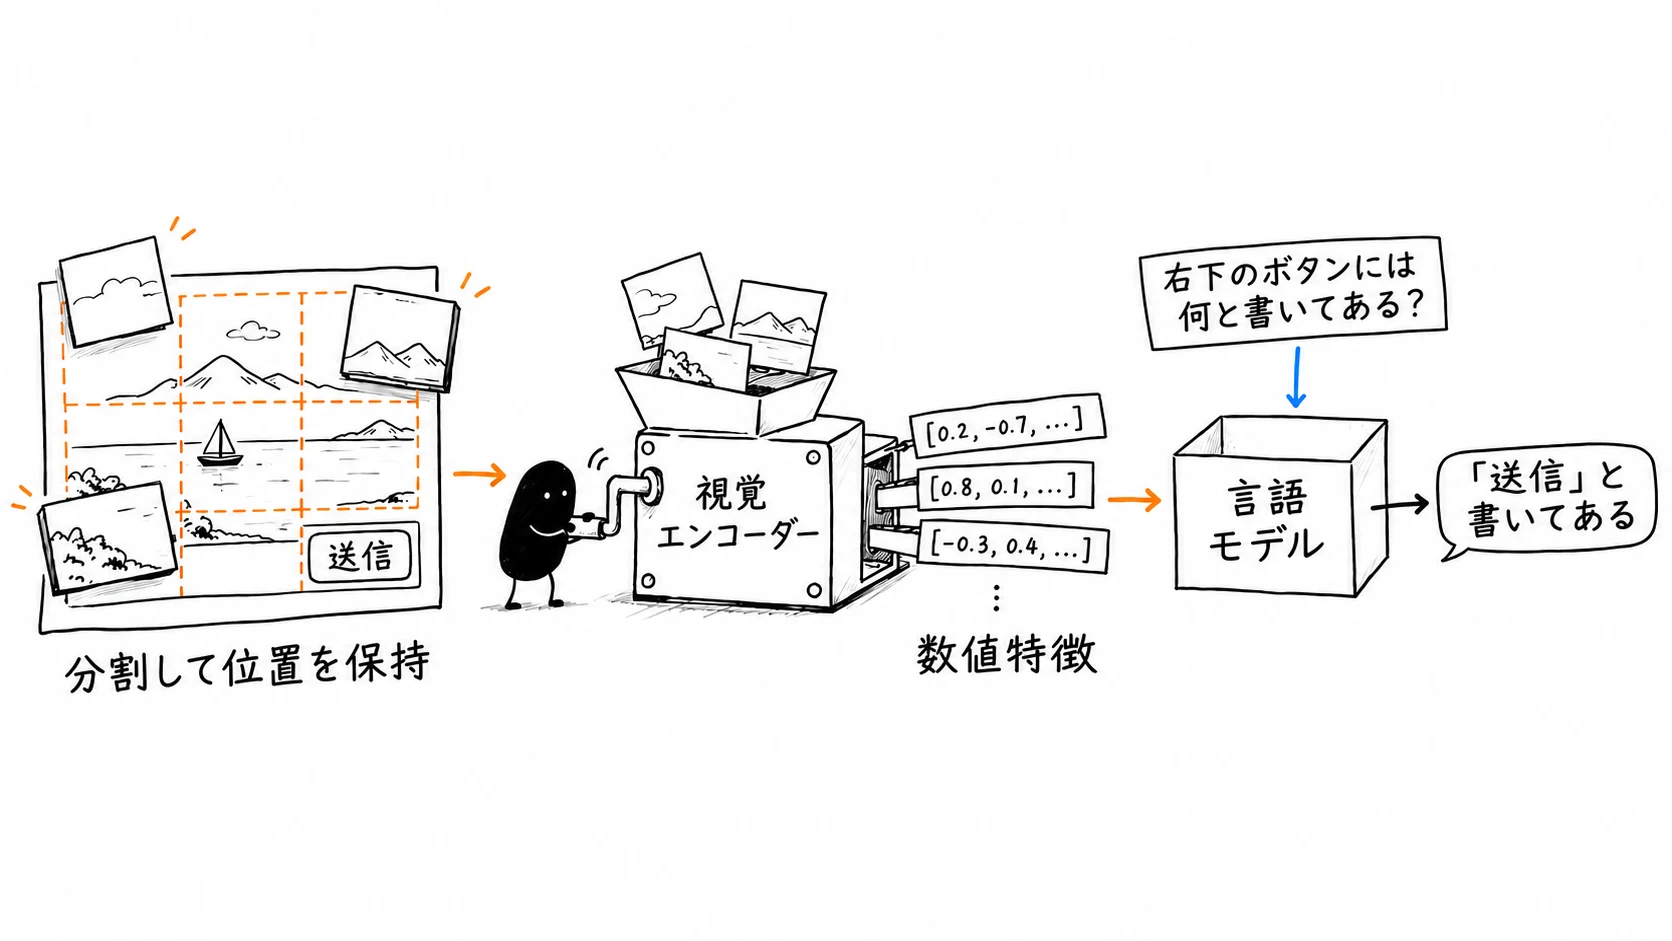
ステップ 1:画像を処理し、適切な領域に分割する。
まず、スクリーンショットを小さなパッチに分けます。同時に、最初のパッチは左上、次は右上といった位置情報も記録します。パッチは仕組みを理解するためのたとえであり、すべてのモデルが同じ方法で分割するわけではありません。
ステップ 2:視覚エンコーダーで画像を数値表現に変換する。
テキストのトークナイザーに似て、視覚エンコーダーは色、輪郭、形などの視覚情報を、モデルが理解できる数値特徴に変換します。
ステップ 3:次に来るものを引き続き予測する。
画像とトークン化されたテキストを受け取った後は、再び次に来そうなトークンを予測します。

3. モデルはどうやって音を聞くのか
音も画像と同じように、エンコーダーを通して、モデルが処理できる数値の組に変換できます。
ただし、製品でよく見かける音声機能には、異なる経路があります。
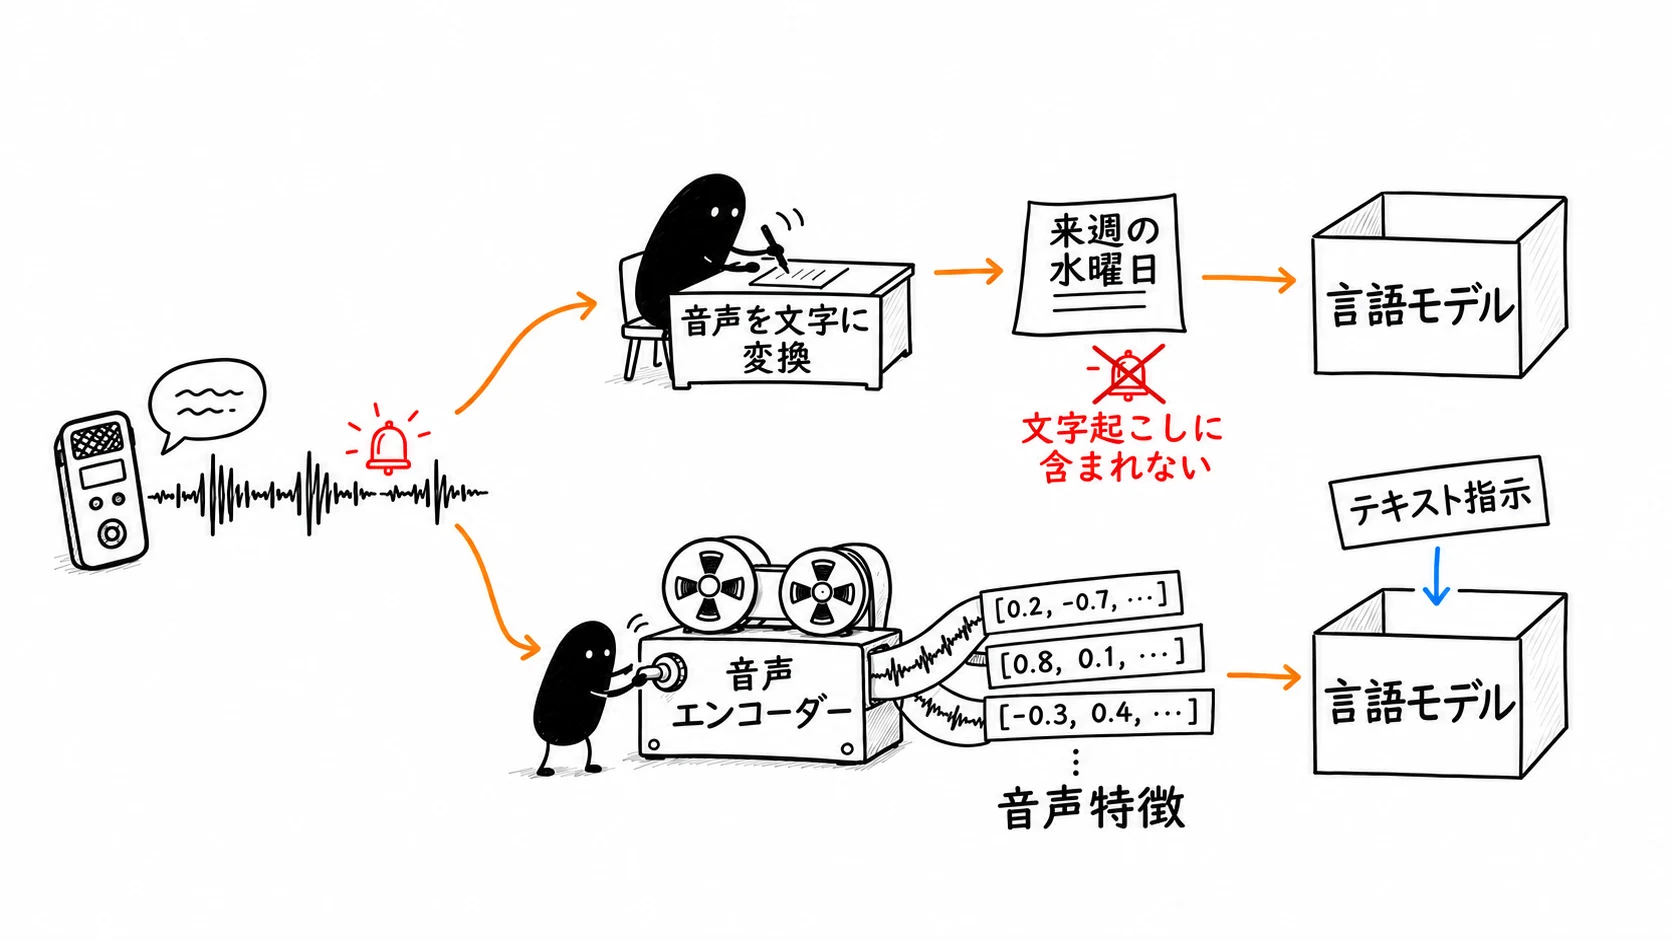
経路 1:文字起こししてから言語モデルに答えてもらう
仕組みは単純です。専用の音声認識技術やモデルが話された言葉をテキストに変換し、そのテキストを大規模言語モデルに渡します。
この場合、言語モデルが受け取るのは文字起こしだけです。背景音、間、口調、感情の変化などは失われることがあります。
経路 2:モデルが音声特徴を受け取る
別の方法では、音声をエンコーダーに通し、その特徴をテキストの指示と一緒にモデルへ渡します。モデルは話し声を処理でき、その能力によっては背景音や音楽も処理できます。
音声特徴を受け取れるからといって、音声を生成できるとは限りません。音を理解するモデルと、音を作るモデルは別の場合があります。