

モデルはどのように事前学習するのか
学習データ、モデルのパラメーター、知識の期限を理解し、生成された回答に確認が必要な理由を学びます。
ここまで、モデルが入力とパラメーターを使ってトークンの確率を計算する仕組みを見てきました。このレッスンでは、簡単な例で、事前学習によってパラメーターが決まる過程を説明します。学習アルゴリズムを覚える必要はありません。
1. 事前学習の全体像
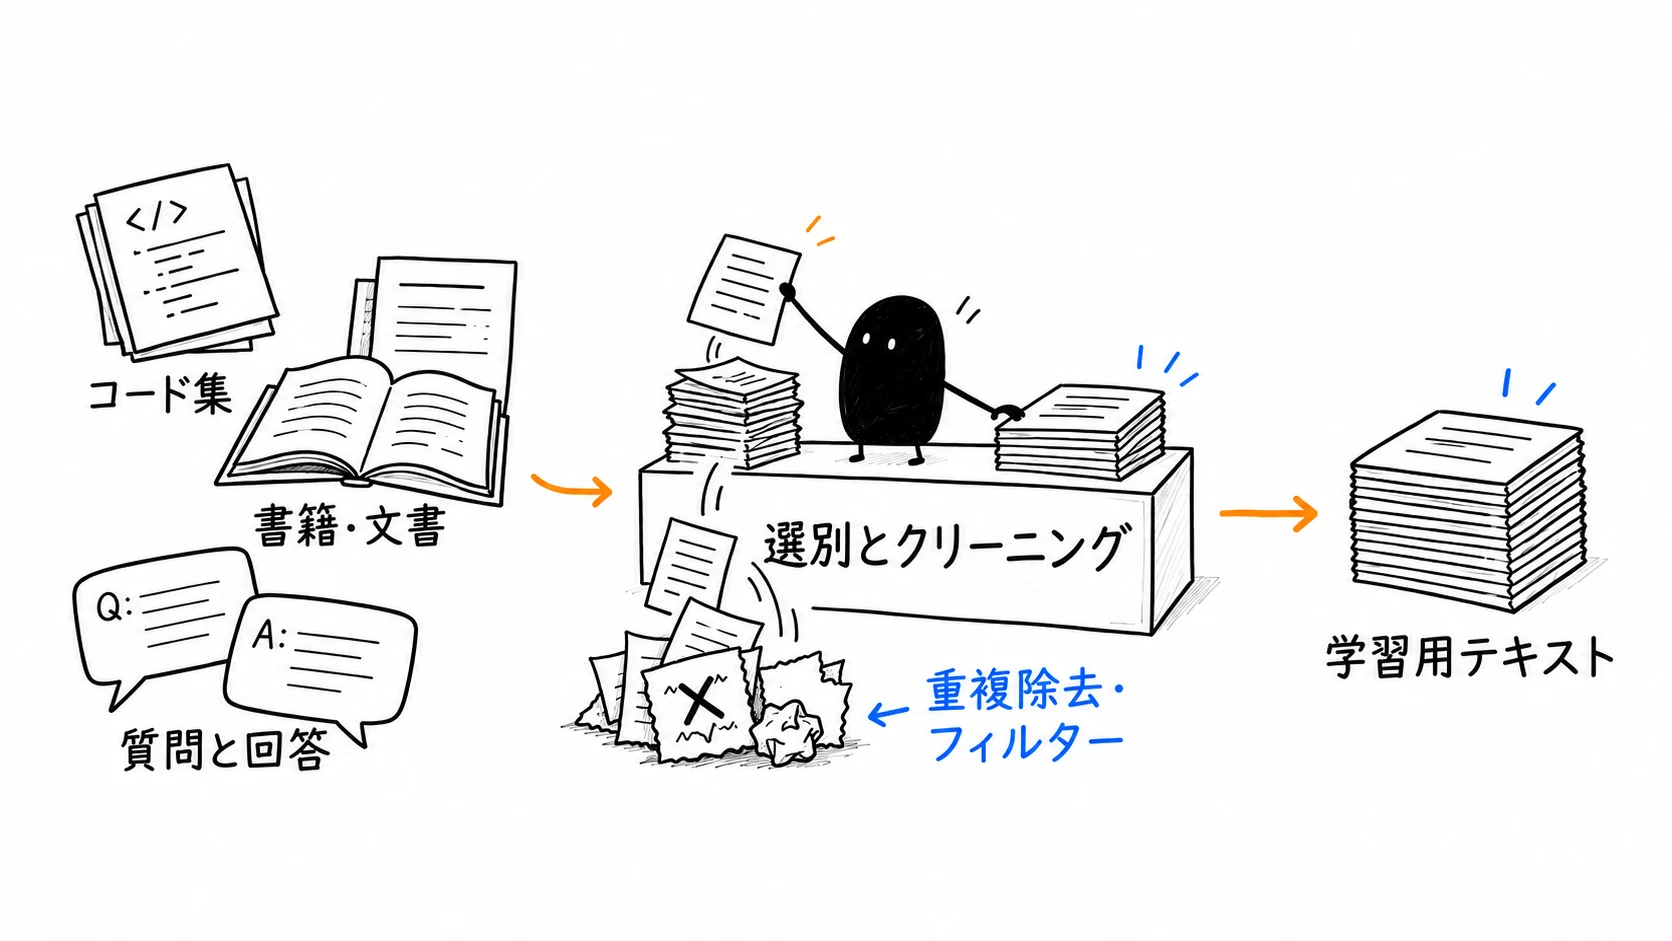
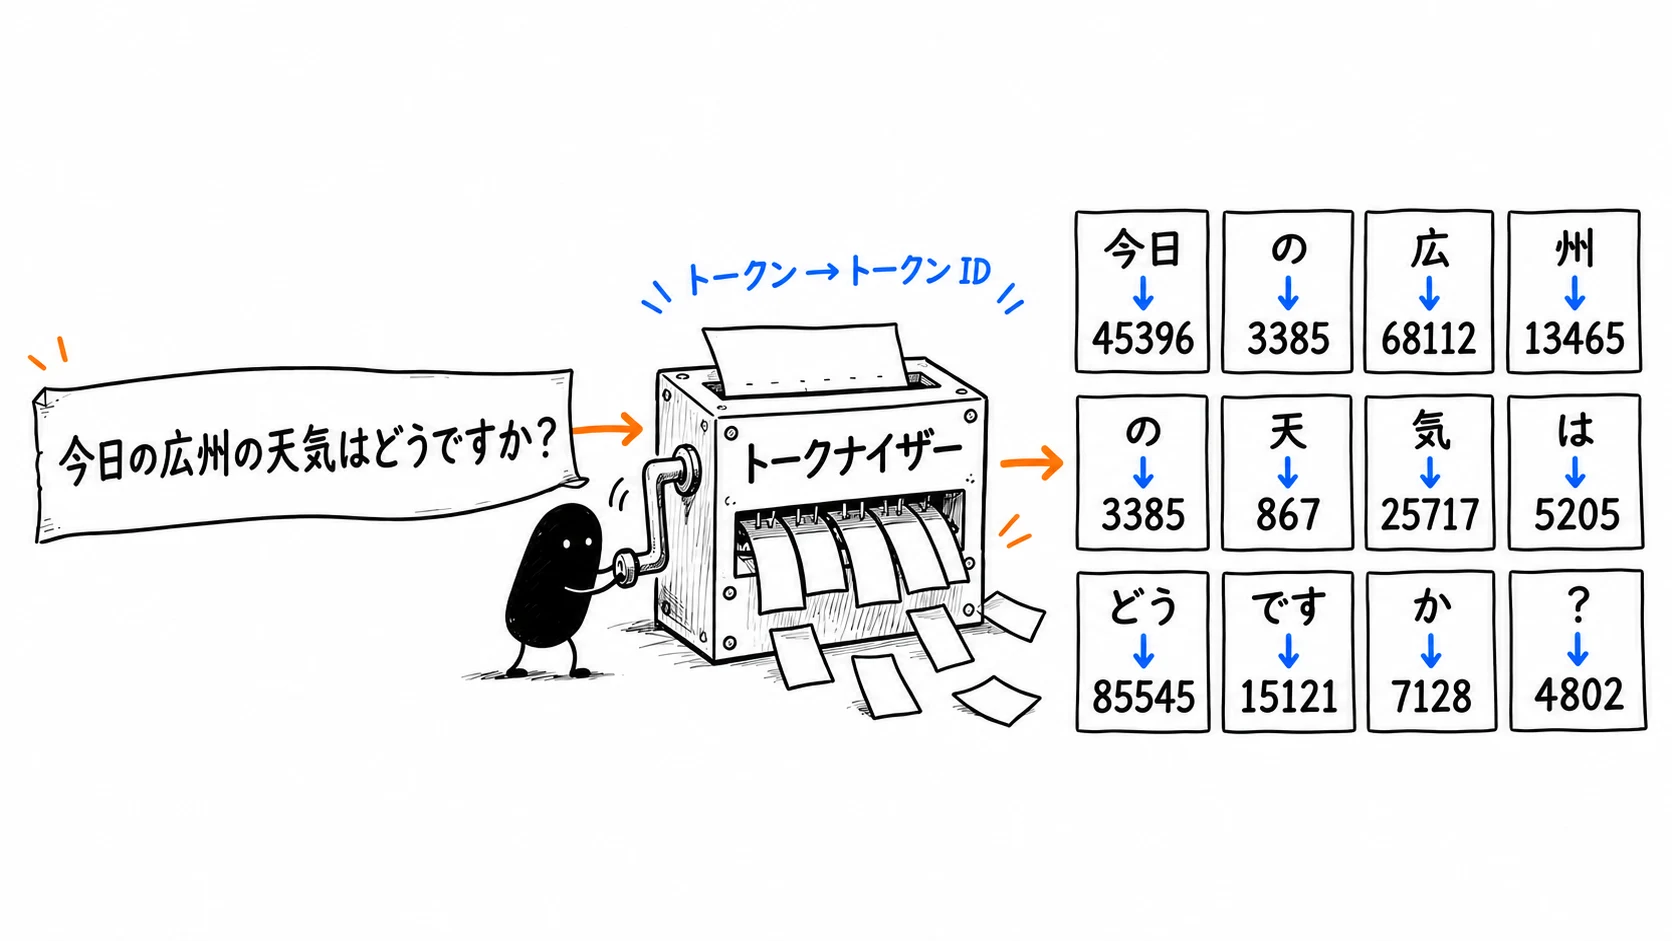
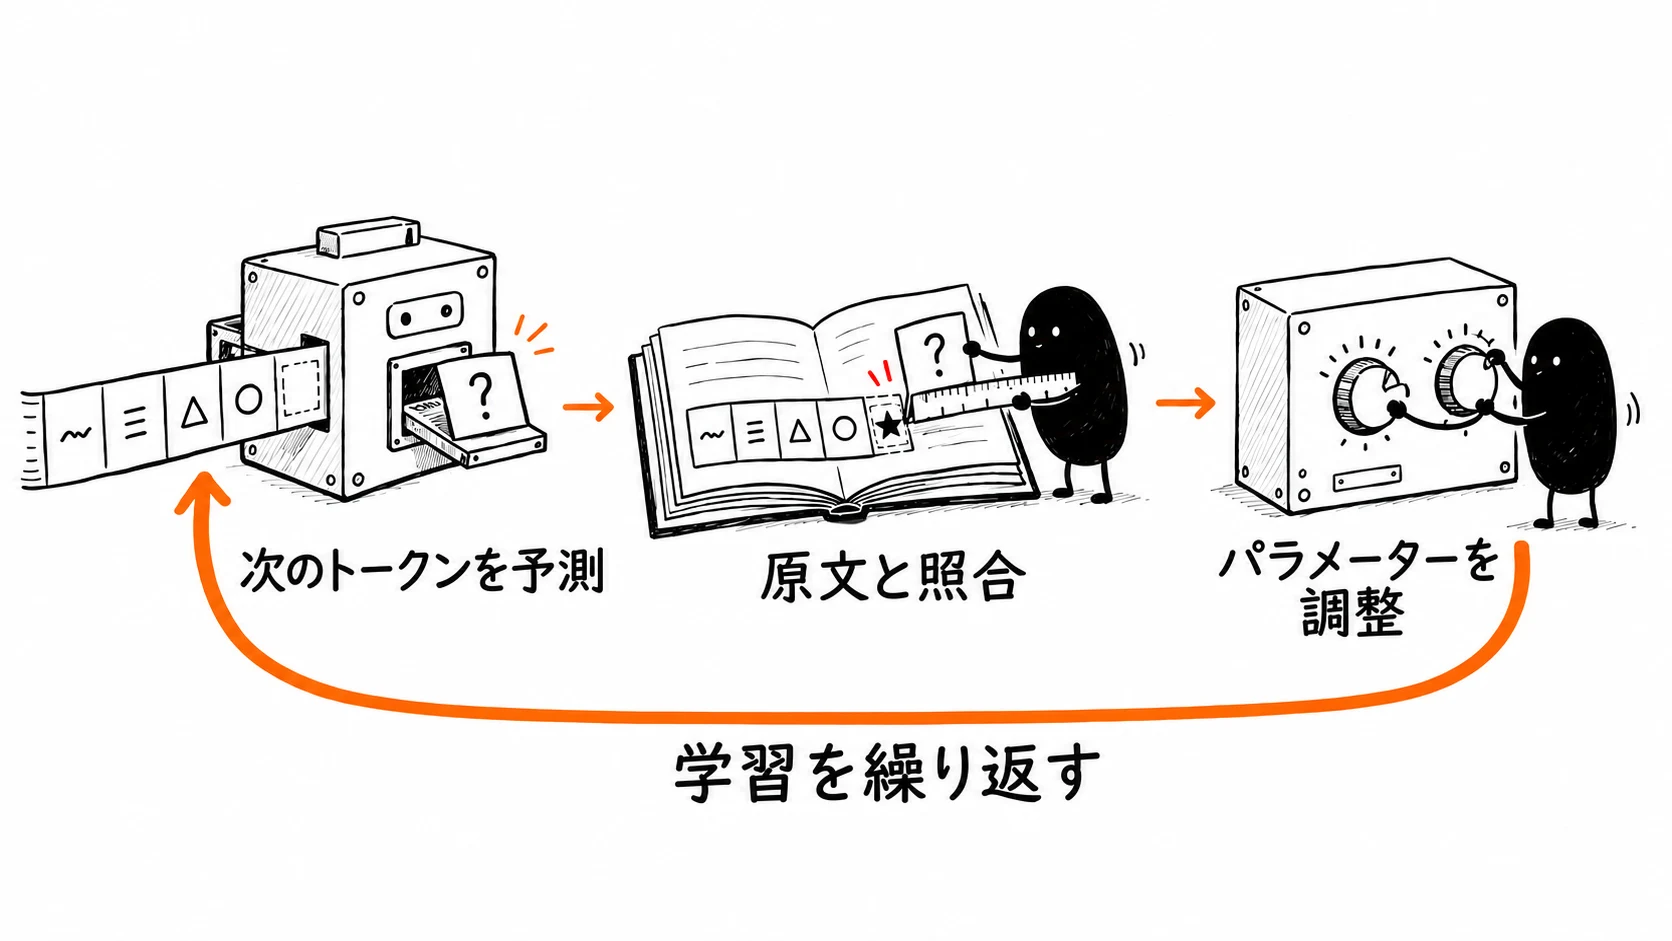
事前学習では、大量のテキストから言語の規則性を学びます。大まかには、次の 3 つの段階があります。
2. 事前学習はどのように進むのか

おおよその流れは次のとおりです。
ステップ 0:パラメーターを初期化する。
前のレッスンと同じ式、スコア = a × 入力 + b を使います。
学習を始める時点では、a と b はまだ学習されていないので、初期値を設定します。各候補には、それぞれの a と b があります。たとえば「傘」は a = 0.50、b = 1.10 から始めます。この段階ではパラメーターを初期化するだけで、入力を使ったスコアや確率の計算はまだ行いません。
ステップ 1:テキストを読み、次のトークンを予測する。
初期パラメーターを使ってテキストを読み、次のトークンを予測します。たとえば、入力は「今日は雨。出かけるときに持っていくのは…」です。
この簡略化した例では、雨を入力 x = 1 で表します。3 つの候補への入力は同じですが、パラメーターが異なるため、スコアも異なります。
次に、Softmax でスコアを合計 100% の確率に変換します。
| 候補 | スコアの計算 | スコア | Softmax の確率 |
|---|---|---|---|
| 傘 | 0.50 × 1 + 1.10 | 1.60 | 約 24.78% |
| レインコート | 1.00 × 1 + 1.08 | 2.08 | 約 40.05% |
| 帽子 | 0.80 × 1 + 1.15 | 1.95 | 約 35.17% |
ステップ 2:正解を確認する。
学習データの原文「今日は雨。出かけるときに持っていくのは傘」を確認します。正解は「傘」です。
ステップ 3:パラメーターを調整する。
正解を確認したら、モデルのパラメーターを調整します。
先ほどの予測では、「レインコート」の確率が約 40% で最も高く、正解の「傘」は約 25% しかありませんでした。差がかなりあります。学習プログラムは正解との差を測り、この入力で「傘」の確率が上がるようにパラメーターを調整します。
たとえば「傘」のパラメーターを a = 0.60、b = 1.20 に変え、ほかの候補も調整します。入力は x = 1 のままで、スコアと確率は次のようになります。
| 候補 | スコアの計算 | スコア | Softmax の確率 |
|---|---|---|---|
| 傘 | 0.60 × 1 + 1.20 | 1.80 | 約 44.95% |
| レインコート | 0.40 × 1 + 1.00 | 1.40 | 約 30.13% |
| 帽子 | 0.30 × 1 + 0.91 | 1.21 | 約 24.92% |
入力は変わっていません。変わったのはパラメーターと候補のスコアです。この調整によって、「傘」の予測確率が約 25% から約 45% に上がりました。
一連の流れをデモで確認しましょう。
- 00初期化
- 01予測
- 02照合
- 03調整
ステップ 4:予測、照合、パラメーターの更新を繰り返す。
初期化は学習開始時の 1 回だけです。その後は予測し、原文と照合し、その差に応じてパラメーターを調整します。各ラウンドで初期値に戻すわけではありません。
この調整は一度で終わるものではなく、何度も繰り返す必要があります。次のデモでは入力を固定し、学習ラウンドごとに「傘」の確率がどう変わるかを示します。
- 学習前25%
- 1 回目の後—
- 2 回目の後—
- 3 回目の後—
学習を何度も繰り返すと、モデルは言語の統計的な規則性を学び、文法に沿った一貫性のある文章を生成できるようになります。テキストの意味を理解し、文法や論理に沿った文章を生成できます。こうして得られるのが、ベースモデルです。
3. これが何に役立つのか
覚えておきたい重要な概念があります。モデルの学習データには時間的な期限があります。
つまり、モデルが答えられるのは、学習データの期限より前の情報に関する質問です。ほかのツール(简体中文)を使わなければ、学習データにない情報を取得できません。たとえば GPT-6 の学習データは 2026 年 4 月までなので、4 月より後の出来事は知りません。
もう 1 つ重要なのは、学習時の「正解」は、事実として正しいとは限らないという点です。
先ほど「正解を確認する」と説明しました。ここでの正解とは、学習テキストの次のトークンです。そのテキストには、誤り、偏り、フィクションが含まれることがあります。原文を正しく予測しても、そこから学んだ内容がすべて事実になるわけではありません。
たとえば、学習データがすべて「1 週間は 6 日」と書いてあれば、モデルは 1 週間を 6 日と考えます。