

Comment préentraîne-t-on un modèle ?
Comprendre les données d’entraînement, les paramètres et la date limite des connaissances, ainsi que la nécessité de vérifier les réponses générées.
Nous avons vu comment un modèle utilise son entrée et ses paramètres pour calculer les probabilités des tokens. Cette leçon explique, avec des exemples simples, comment le préentraînement produit ces paramètres. Il n’est pas nécessaire d’apprendre les algorithmes d’entraînement.
1. Vue d’ensemble du préentraînement
Le préentraînement permet au modèle d’apprendre les régularités du langage à partir de grandes quantités de texte. Pour simplifier, il comprend trois étapes :
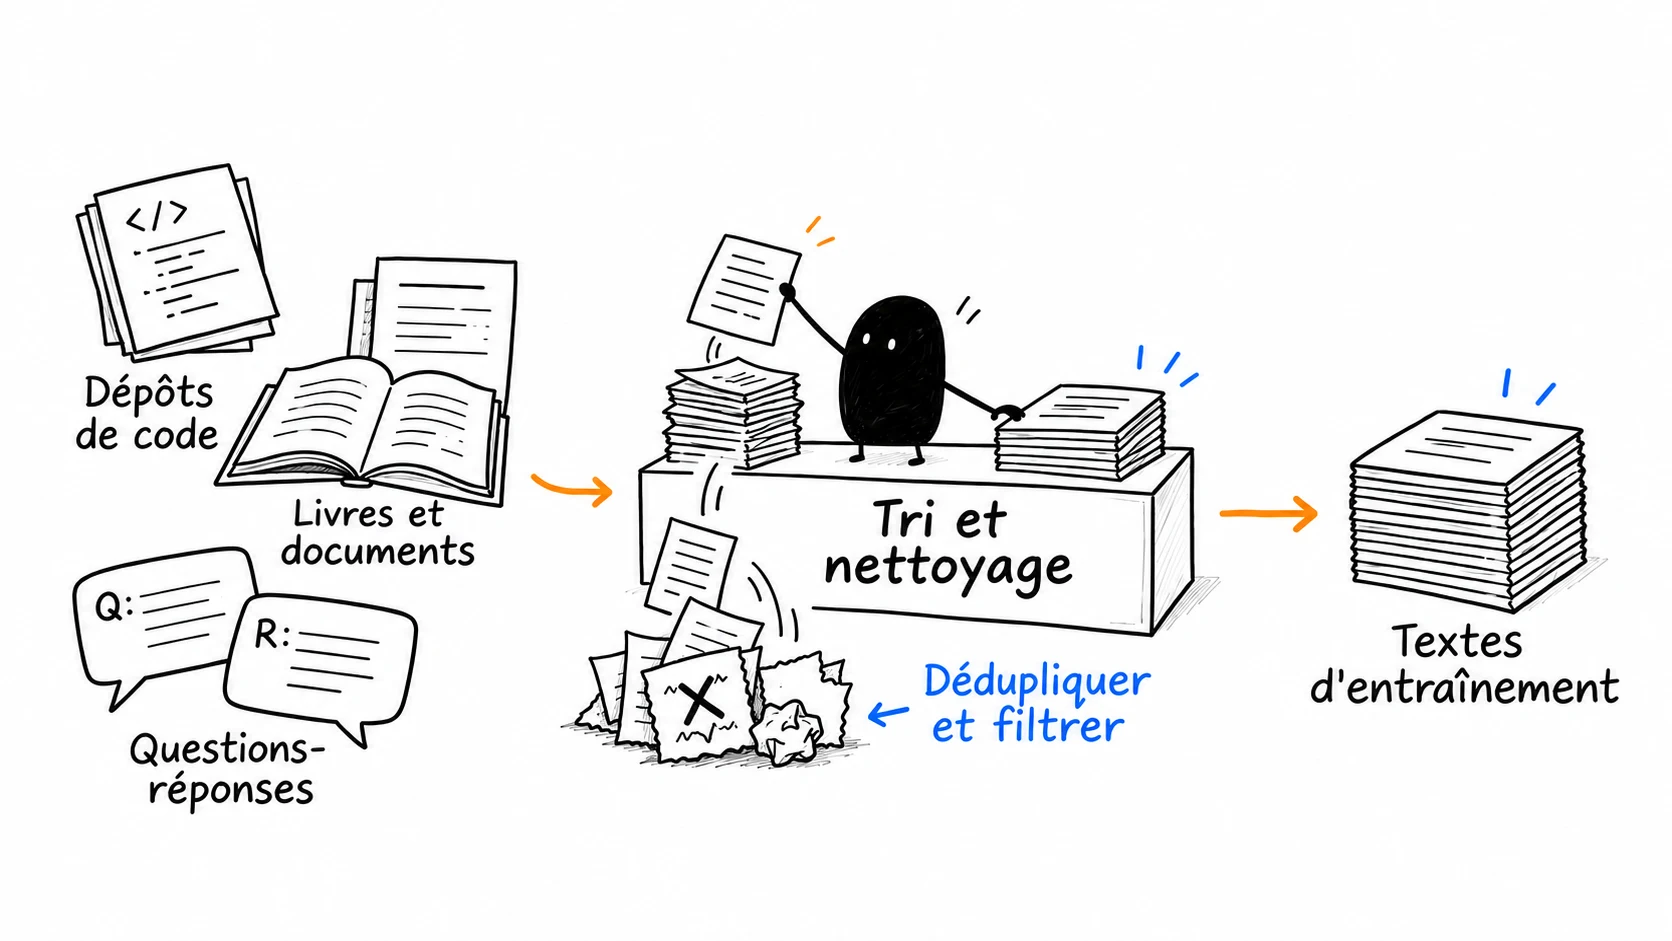
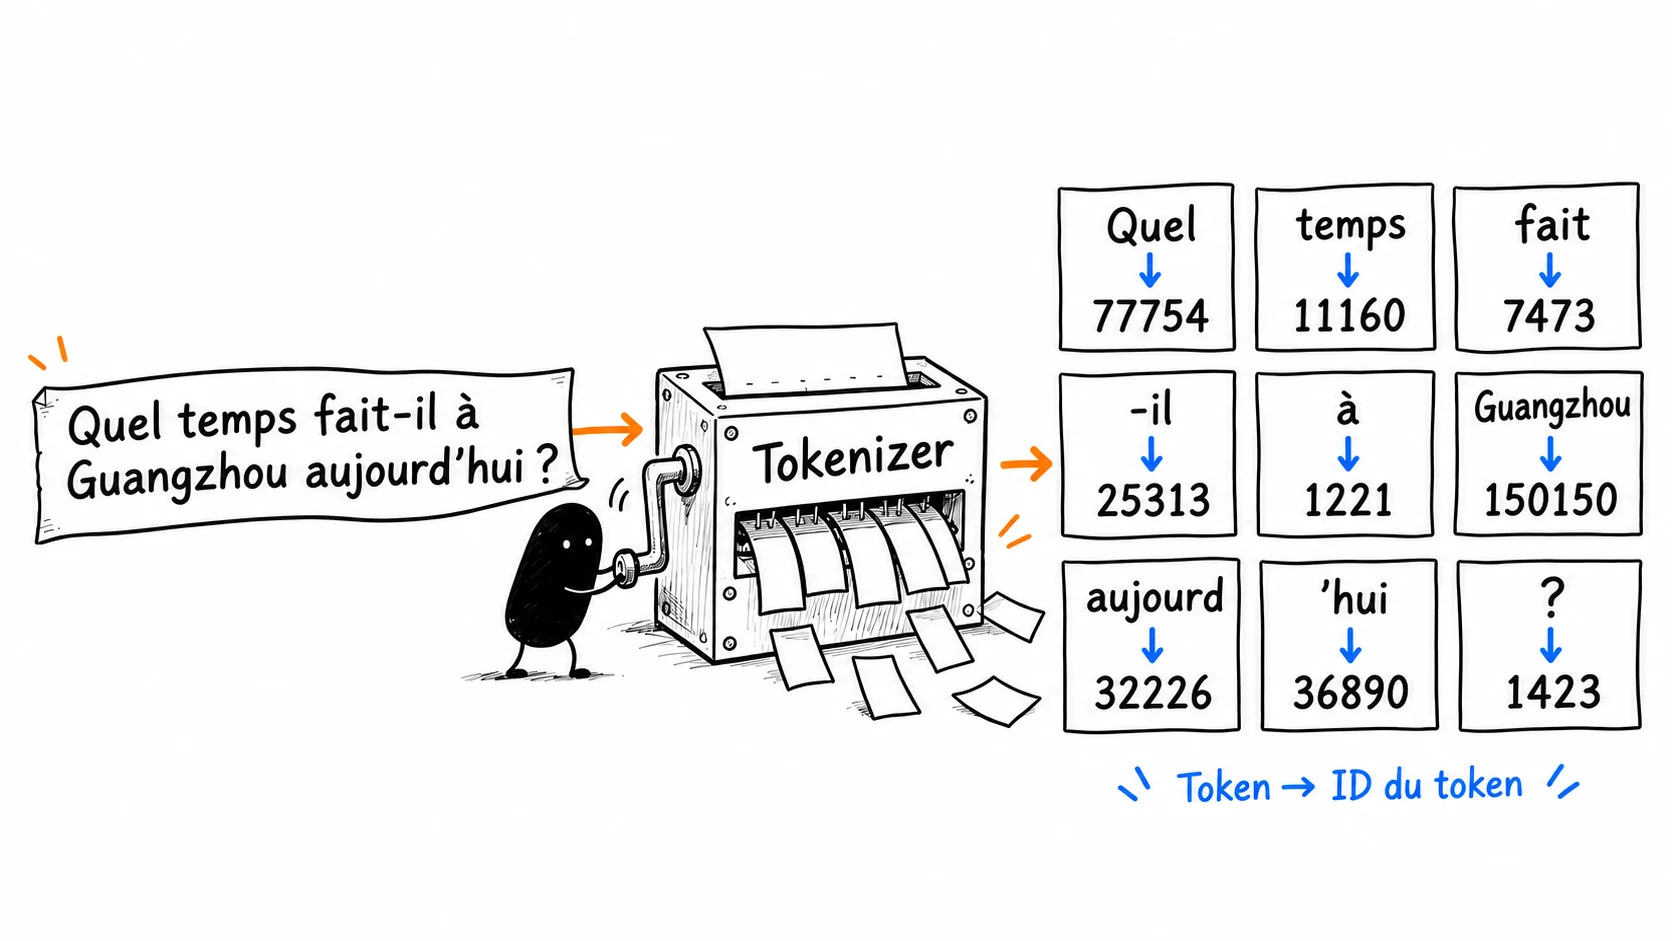
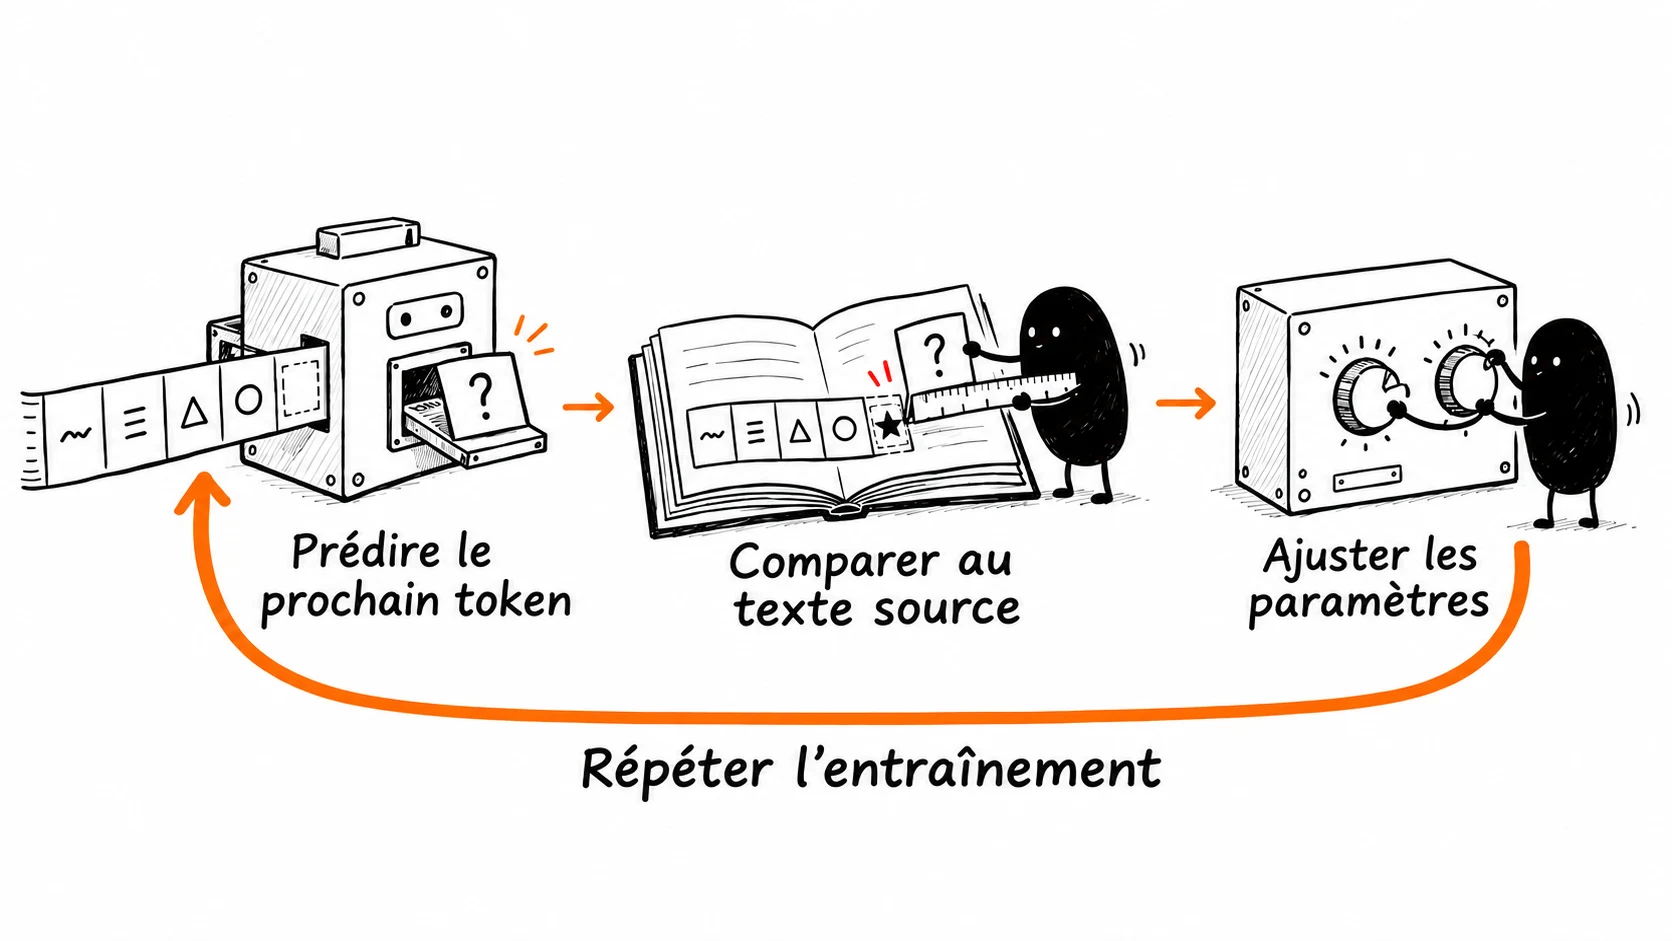
2. Comment fonctionne le préentraînement ?

Voici le déroulement général.
Étape 0 : initialiser les paramètres.
Reprenons la formule précédente : score = a × entrée + b.
Au début de l’entraînement, a et b n’ont pas encore été appris : on leur attribue des valeurs initiales. Chaque candidat possède ses propres a et b. Par exemple, pour « parapluie », on commence avec a = 0.50 et b = 1.10. Cette étape initialise uniquement les paramètres. Elle ne calcule pas encore de scores ni de probabilités à partir d’une entrée.
Étape 1 : lire un texte et prédire le prochain token.
Avec ces paramètres initiaux, le modèle lit un passage et prédit le prochain token. Prenons l’entrée « Il pleut aujourd’hui. Pense à prendre ton… ».
Dans cet exemple simplifié, la pluie correspond à l’entrée x = 1. Les trois candidats reçoivent la même entrée, mais leurs paramètres diffèrent, donc leurs scores aussi.
Softmax convertit ensuite les scores en probabilités dont la somme vaut 100 %.
| Candidat | Calcul du score | Score | Probabilité Softmax |
|---|---|---|---|
| parapluie | 0.50 × 1 + 1.10 | 1,60 | environ 24,78 % |
| imperméable | 1.00 × 1 + 1.08 | 2,08 | environ 40,05 % |
| chapeau | 0.80 × 1 + 1.15 | 1,95 | environ 35,17 % |
Étape 2 : consulter la bonne réponse.
Le modèle consulte le texte original des données d’entraînement : « Il pleut aujourd’hui. Pense à prendre ton parapluie ». La bonne réponse est « parapluie ».
Étape 3 : ajuster les paramètres.
Après avoir consulté la bonne réponse, on ajuste les paramètres du modèle.
La prédiction précédente donnait la probabilité la plus élevée à « imperméable », environ 40 %. La bonne réponse, « parapluie », n’obtenait qu’environ 25 %. L’écart est important. Le programme d’entraînement mesure cet écart par rapport à la bonne réponse, puis ajuste les paramètres pour augmenter la probabilité de « parapluie » avec cette entrée.
Par exemple, il passe les paramètres de « parapluie » à a = 0.60 et b = 1.20, tout en ajustant ceux des autres candidats. L’entrée reste x = 1, ce qui donne les scores et probabilités suivants :
| Candidat | Calcul du score | Score | Probabilité Softmax |
|---|---|---|---|
| parapluie | 0.60 × 1 + 1.20 | 1,80 | environ 44,95 % |
| imperméable | 0.40 × 1 + 1.00 | 1,40 | environ 30,13 % |
| chapeau | 0.30 × 1 + 0.91 | 1,21 | environ 24,92 % |
L’entrée n’a pas changé. Ce sont les paramètres et les scores des candidats qui ont changé. Après cet ajustement, la probabilité prédite de « parapluie » passe d’environ 25 % à environ 45 %.
Voici une démonstration de l’ensemble du processus :
- 00Initialiser
- 01Prédire
- 02Comparer
- 03Ajuster
Étape 4 : répéter la prédiction, la comparaison et la mise à jour des paramètres.
L’initialisation n’a lieu qu’une fois, au début de l’entraînement. Ensuite, le programme prédit, compare avec le texte source et ajuste les paramètres selon l’écart, à répétition. Il ne rétablit pas les valeurs initiales à chaque tour.
Cet ajustement ne se fait pas en une seule fois : il doit être répété de nombreuses fois. La démonstration suivante conserve la même entrée pour montrer l’évolution de la probabilité de « parapluie » au fil des tours.
- Avant25%
- Après le tour 1—
- Après le tour 2—
- Après le tour 3—
Après de nombreux tours d’entraînement, le modèle a appris des régularités statistiques du langage et peut produire des textes cohérents et grammaticaux. Il peut comprendre le sens d’un texte et en générer un qui respecte la grammaire et la logique. On obtient ainsi un modèle de base.
3. À quoi cela sert-il ?
Un concept important est à retenir : les données d’entraînement d’un modèle ont une date limite.
Autrement dit, le modèle ne peut répondre qu’à propos d’informations antérieures à cette limite. Sans autres outils (简体中文), il ne peut pas obtenir d’informations absentes de ses données d’entraînement. Par exemple, les données de GPT-6 s’arrêtent en avril 2026 : il ne peut donc pas connaître les événements survenus après avril.
Autre concept important : la « bonne réponse » pendant l’entraînement n’est pas nécessairement exacte sur le plan factuel.
Nous avons dit que le modèle consulte la bonne réponse. Ici, il s’agit du prochain token dans le texte d’entraînement. Ce texte peut contenir des erreurs, des biais ou de la fiction. Prédire correctement le texte source ne rend pas factuel tout ce qu’on en apprend.
Par exemple, si toutes les données d’entraînement affirment qu’« une semaine compte six jours », le modèle pensera qu’une semaine compte six jours.