

¿Cómo se preentrena un modelo?
Comprende los datos de entrenamiento, los parámetros y el límite temporal del conocimiento, y por qué hay que verificar las respuestas generadas.
Ya hemos visto cómo un modelo usa la entrada y sus parámetros para calcular las probabilidades de los tokens. En esta lección veremos, con ejemplos sencillos, cómo el preentrenamiento produce esos parámetros. No necesitas aprender los algoritmos de entrenamiento.
1. Una visión general del preentrenamiento
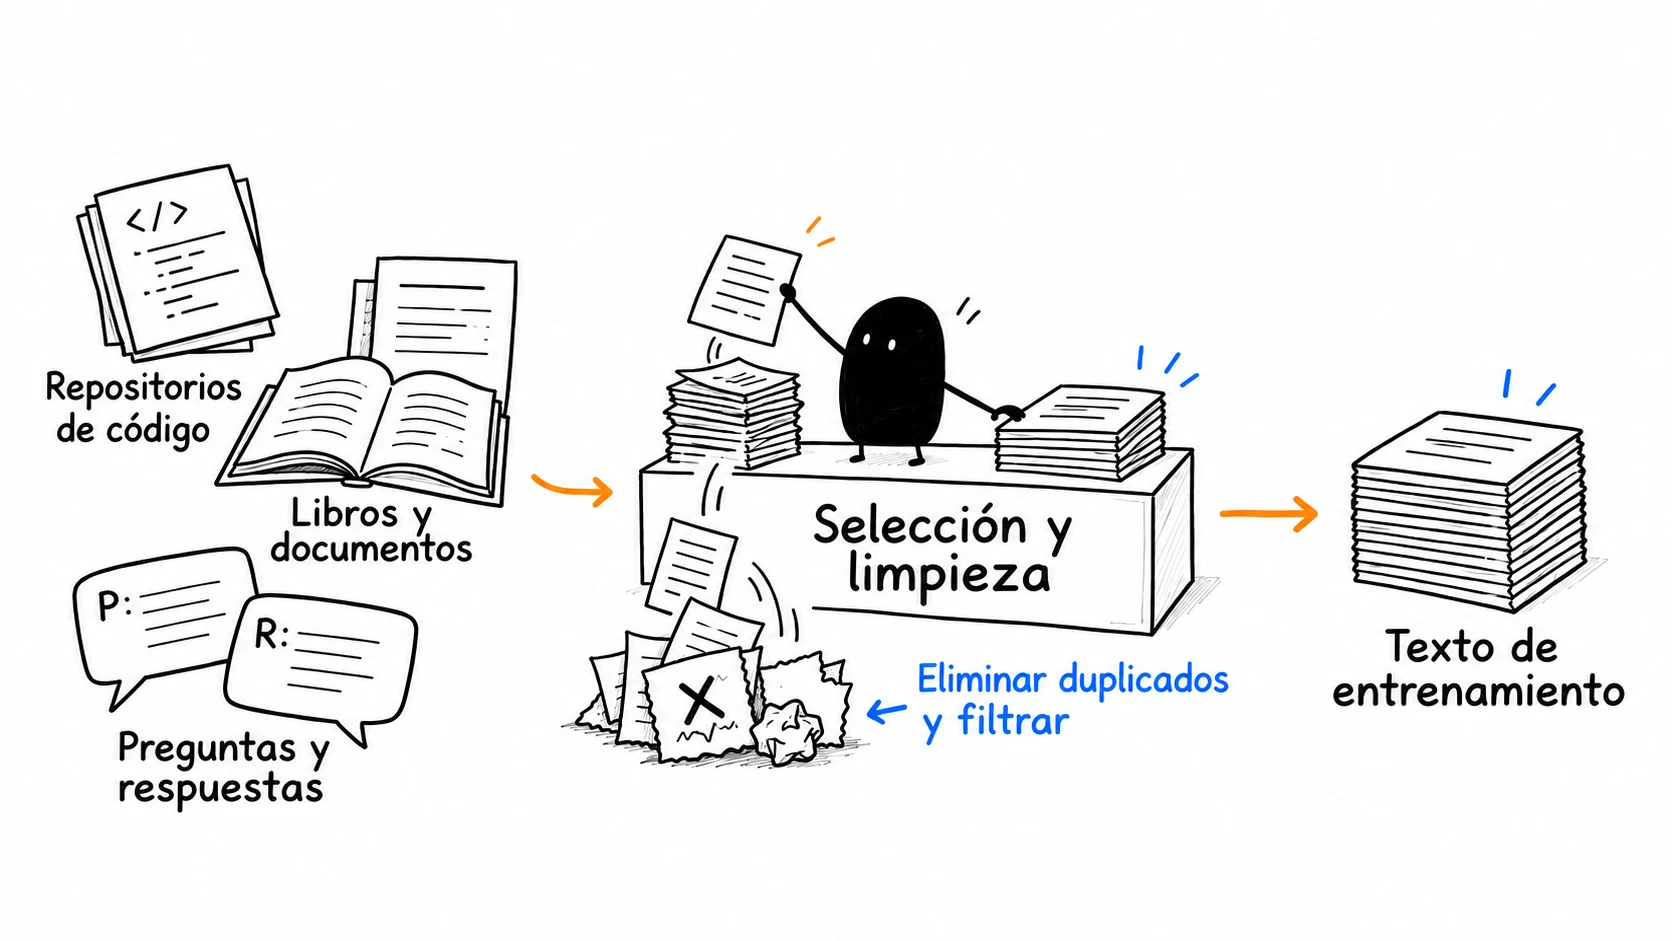
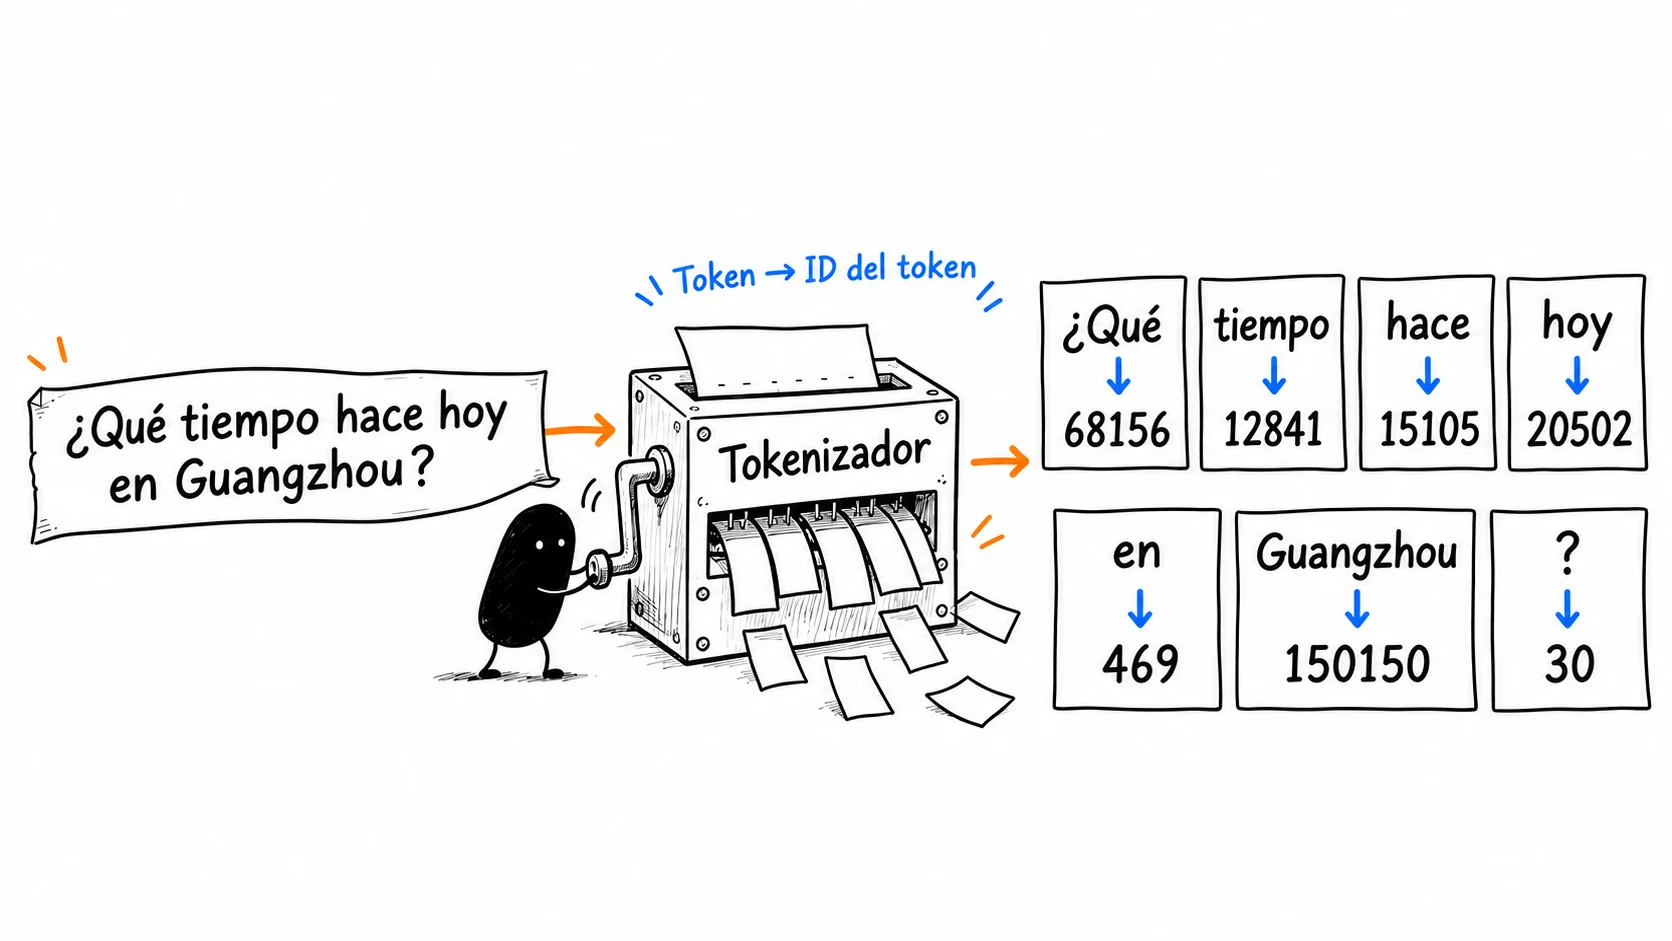
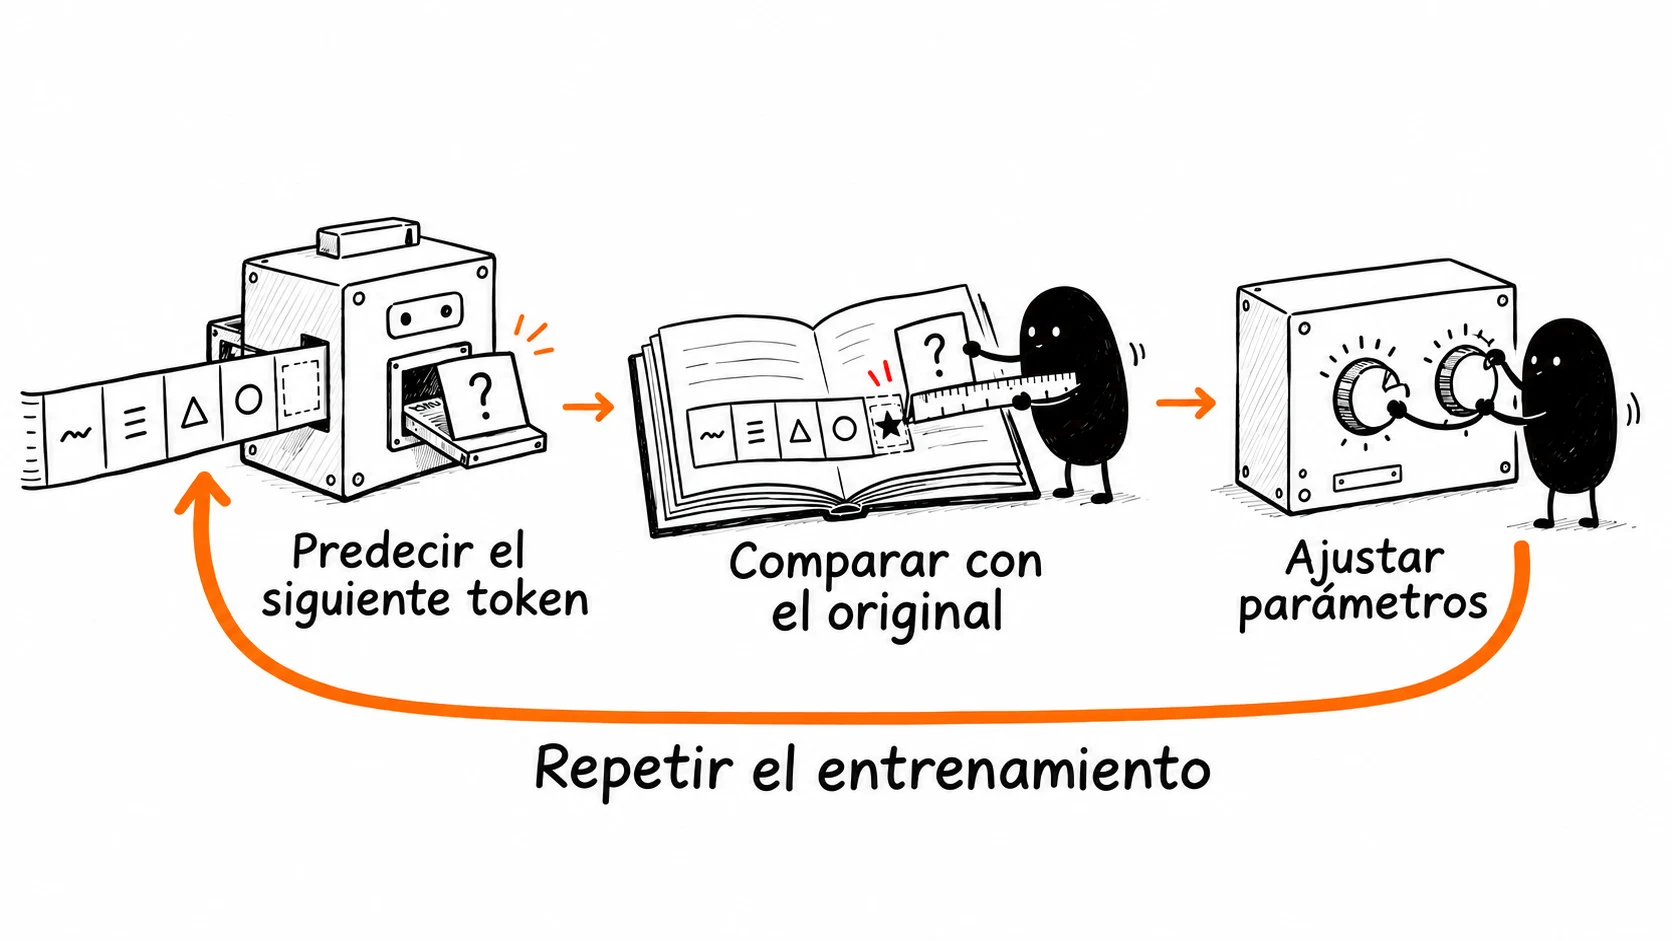
El preentrenamiento permite que un modelo aprenda patrones del lenguaje a partir de grandes cantidades de texto. De forma simplificada, consta de tres pasos:
2. ¿Cómo funciona el preentrenamiento?

El proceso funciona aproximadamente así.
Paso 0: inicializar los parámetros.
Seguiremos con la fórmula anterior: puntuación = a × entrada + b.
Al comenzar el entrenamiento, a y b todavía no se han aprendido, por lo que se les asignan valores iniciales. Cada candidato tiene sus propios a y b. Por ejemplo, «paraguas» empieza con a = 0.50 y b = 1.10. Este paso solo inicializa los parámetros. Todavía no calcula puntuaciones ni probabilidades a partir de una entrada.
Paso 1: leer un texto y predecir el siguiente token.
Con esos parámetros iniciales, el modelo lee un fragmento y predice el siguiente token. Por ejemplo, la entrada es «Hoy llueve. Recuerda llevar tu…».
En este ejemplo simplificado, la lluvia se representa mediante la entrada x = 1. Los tres candidatos reciben la misma entrada, pero sus parámetros son distintos y, por tanto, sus puntuaciones también.
Después, Softmax convierte las puntuaciones en probabilidades que suman el 100 %.
| Candidato | Cálculo de la puntuación | Puntuación | Probabilidad de Softmax |
|---|---|---|---|
| paraguas | 0.50 × 1 + 1.10 | 1,60 | aproximadamente 24,78 % |
| impermeable | 1.00 × 1 + 1.08 | 2,08 | aproximadamente 40,05 % |
| sombrero | 0.80 × 1 + 1.15 | 1,95 | aproximadamente 35,17 % |
Paso 2: consultar la respuesta correcta.
El modelo consulta el texto original de los datos de entrenamiento: «Hoy llueve. Recuerda llevar tu paraguas». La respuesta correcta es «paraguas».
Paso 3: ajustar los parámetros.
Tras consultar la respuesta correcta, se ajustan los parámetros del modelo.
La predicción anterior daba la probabilidad más alta a «impermeable», cerca del 40 %. Sin embargo, la respuesta correcta, «paraguas», solo recibía alrededor del 25 %. La diferencia es considerable. El programa de entrenamiento mide esa diferencia respecto a la respuesta correcta y ajusta los parámetros para aumentar la probabilidad de «paraguas» con esta entrada.
Por ejemplo, cambia los parámetros de «paraguas» a a = 0.60 y b = 1.20, y también ajusta los demás candidatos. La entrada sigue siendo x = 1, lo que produce estas puntuaciones y probabilidades:
| Candidato | Cálculo de la puntuación | Puntuación | Probabilidad de Softmax |
|---|---|---|---|
| paraguas | 0.60 × 1 + 1.20 | 1,80 | aproximadamente 44,95 % |
| impermeable | 0.40 × 1 + 1.00 | 1,40 | aproximadamente 30,13 % |
| sombrero | 0.30 × 1 + 0.91 | 1,21 | aproximadamente 24,92 % |
La entrada no ha cambiado. Han cambiado los parámetros y las puntuaciones de los candidatos. Tras este ajuste, la probabilidad predicha de «paraguas» sube de aproximadamente el 25 % al 45 %.
Esta demostración muestra el proceso completo:
- 00Inicializar
- 01Predecir
- 02Comparar
- 03Ajustar
Paso 4: repetir la predicción, la comparación y la actualización de parámetros.
La inicialización solo se realiza una vez, al empezar el entrenamiento. Después, el programa predice, compara con el texto original y ajusta los parámetros según la diferencia, una y otra vez. No restablece los valores iniciales en cada ronda.
Este ajuste no se completa de una vez: hay que repetirlo muchas veces. La siguiente demostración mantiene la misma entrada para mostrar cómo cambia la probabilidad de «paraguas» entre rondas de entrenamiento.
- Antes25%
- Tras la ronda 1—
- Tras la ronda 2—
- Tras la ronda 3—
Después de muchas rondas, el modelo ha aprendido patrones estadísticos del lenguaje y puede generar textos coherentes y gramaticales. Puede comprender el significado de un texto y generar otro que respete la gramática y la lógica. Así obtenemos un modelo base.
3. ¿Para qué sirve saberlo?
Hay un concepto importante que debes recordar: los datos de entrenamiento de un modelo tienen un límite temporal.
Es decir, el modelo solo puede responder sobre información anterior a ese límite. Sin otras herramientas (简体中文), no puede obtener información fuera de sus datos de entrenamiento. Por ejemplo, los datos de GPT-6 llegan hasta abril de 2026, así que no puede conocer lo ocurrido después de abril.
Otro concepto importante es que la «respuesta correcta» durante el entrenamiento no tiene por qué ser verdadera.
Antes dijimos que el modelo consulta la respuesta correcta. Aquí se trata del siguiente token del texto de entrenamiento. Ese texto puede contener errores, sesgos o ficción. Predecir correctamente el original no convierte todo lo aprendido de él en un hecho.
Por ejemplo, si todos los datos de entrenamiento dicen que «una semana tiene seis días», el modelo pensará que una semana tiene seis días.