

模型是如何预训练的?
了解训练数据、模型参数和知识截止时间,以及为什么生成的回答仍需要查证。
前面,我们了解了模型如何根据输入和参数计算 Token 的概率。这一讲,我们用简单的例子看看这些参数是如何通过「预训练」得到的,不需要掌握具体的训练算法。
一、预训练的大致流程
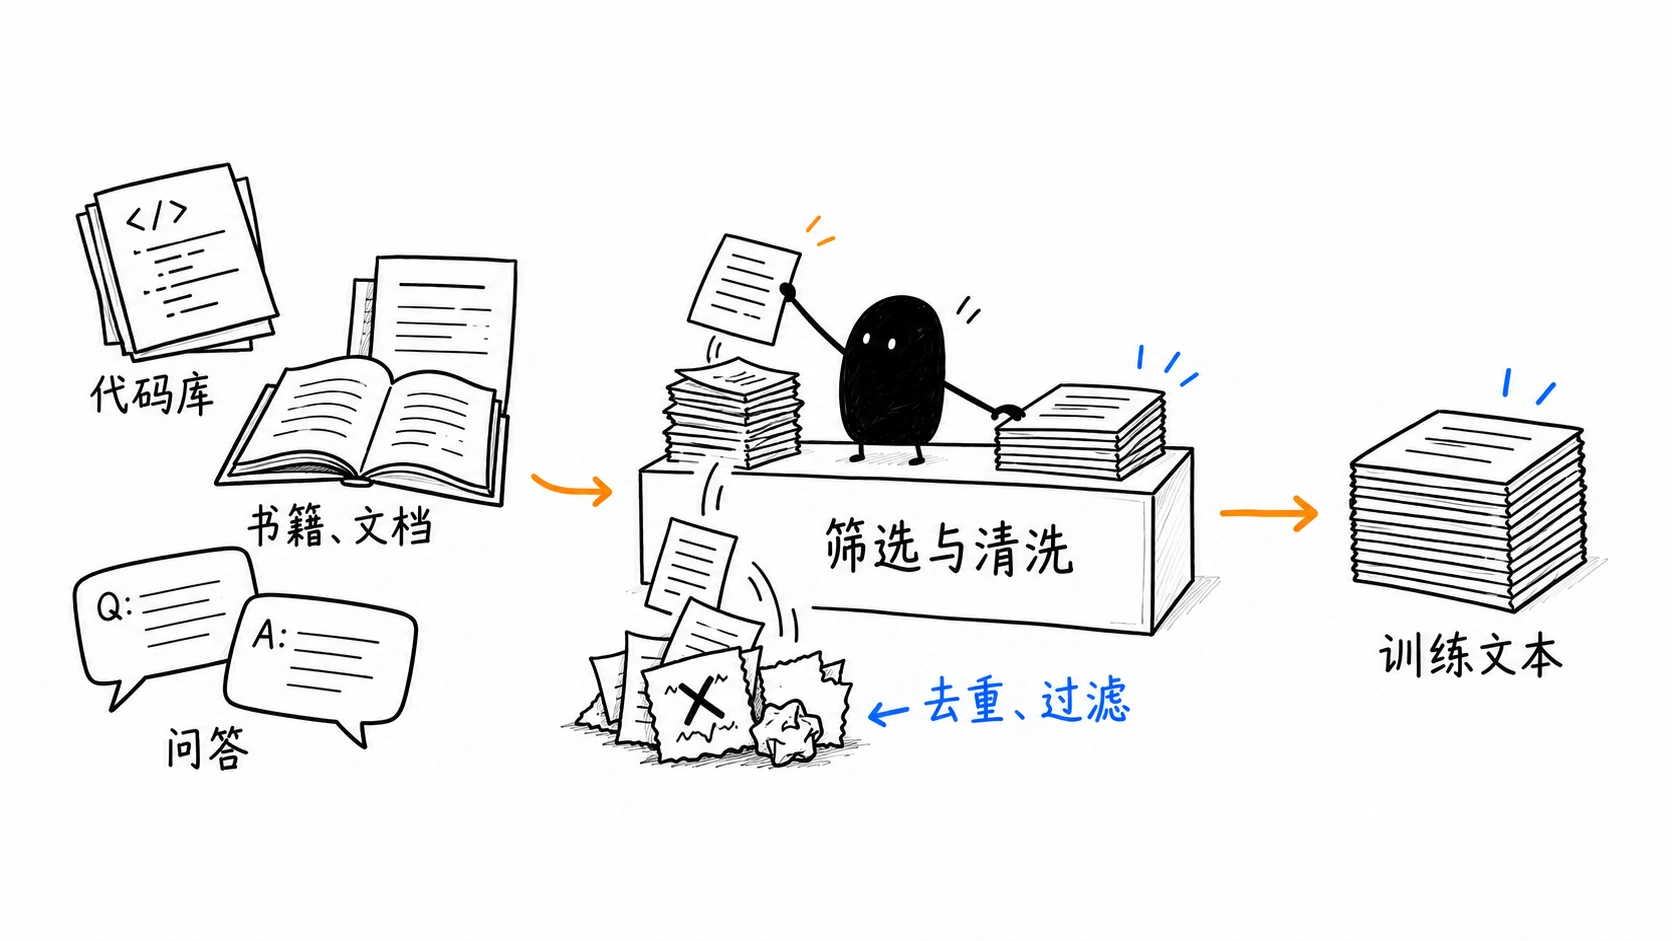
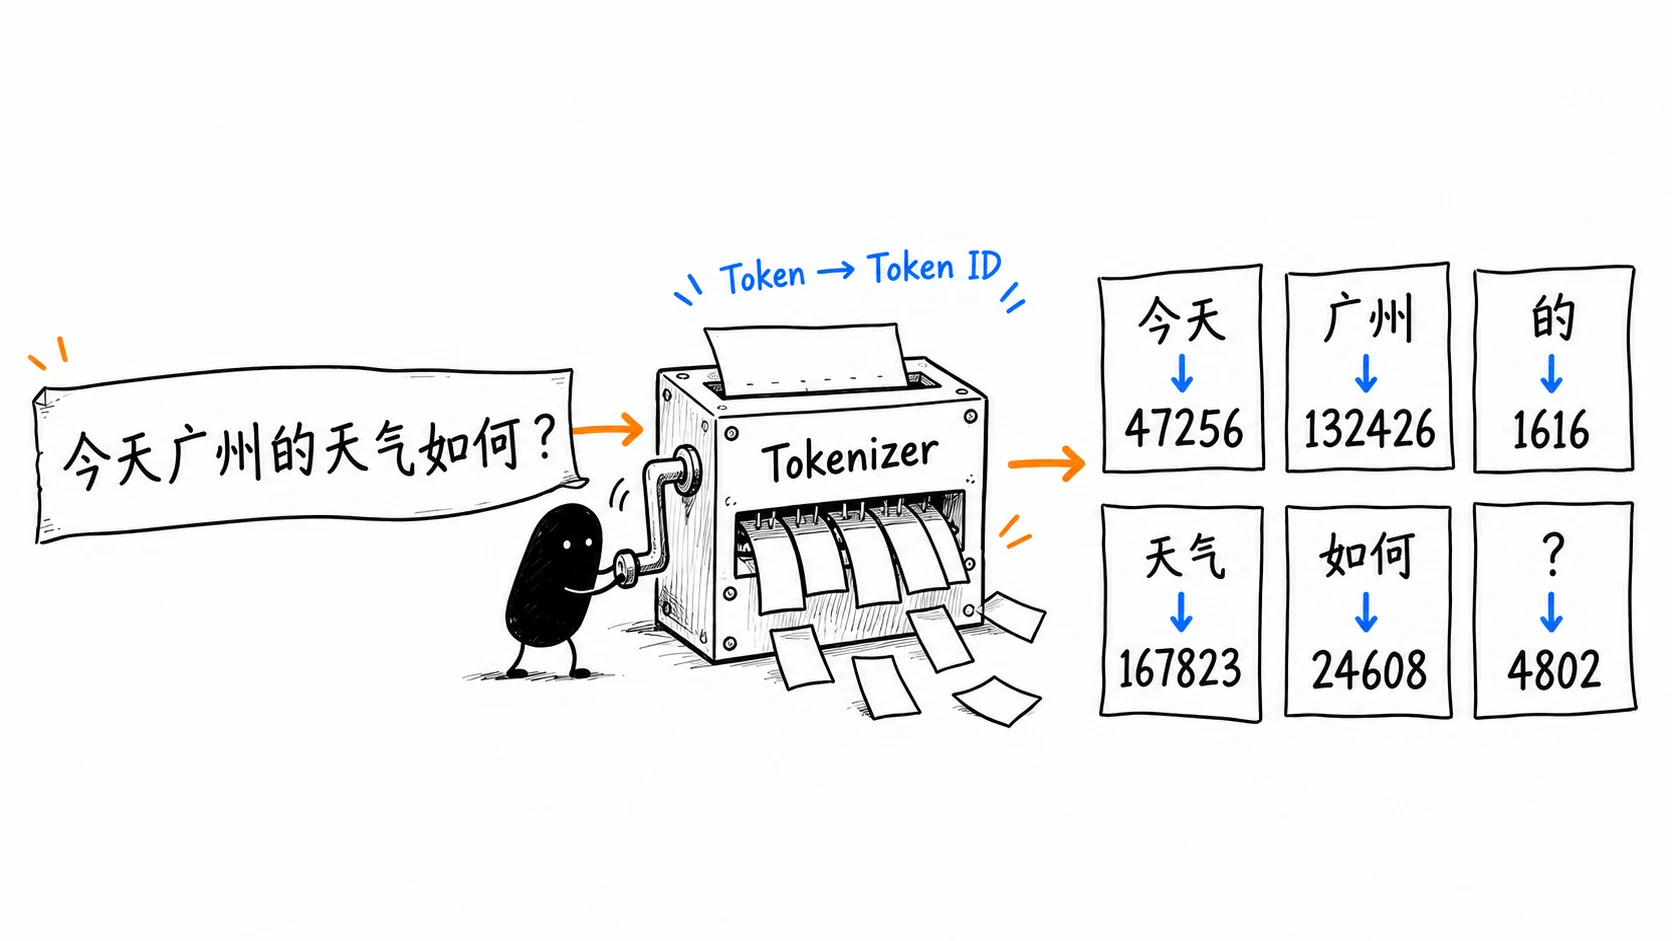
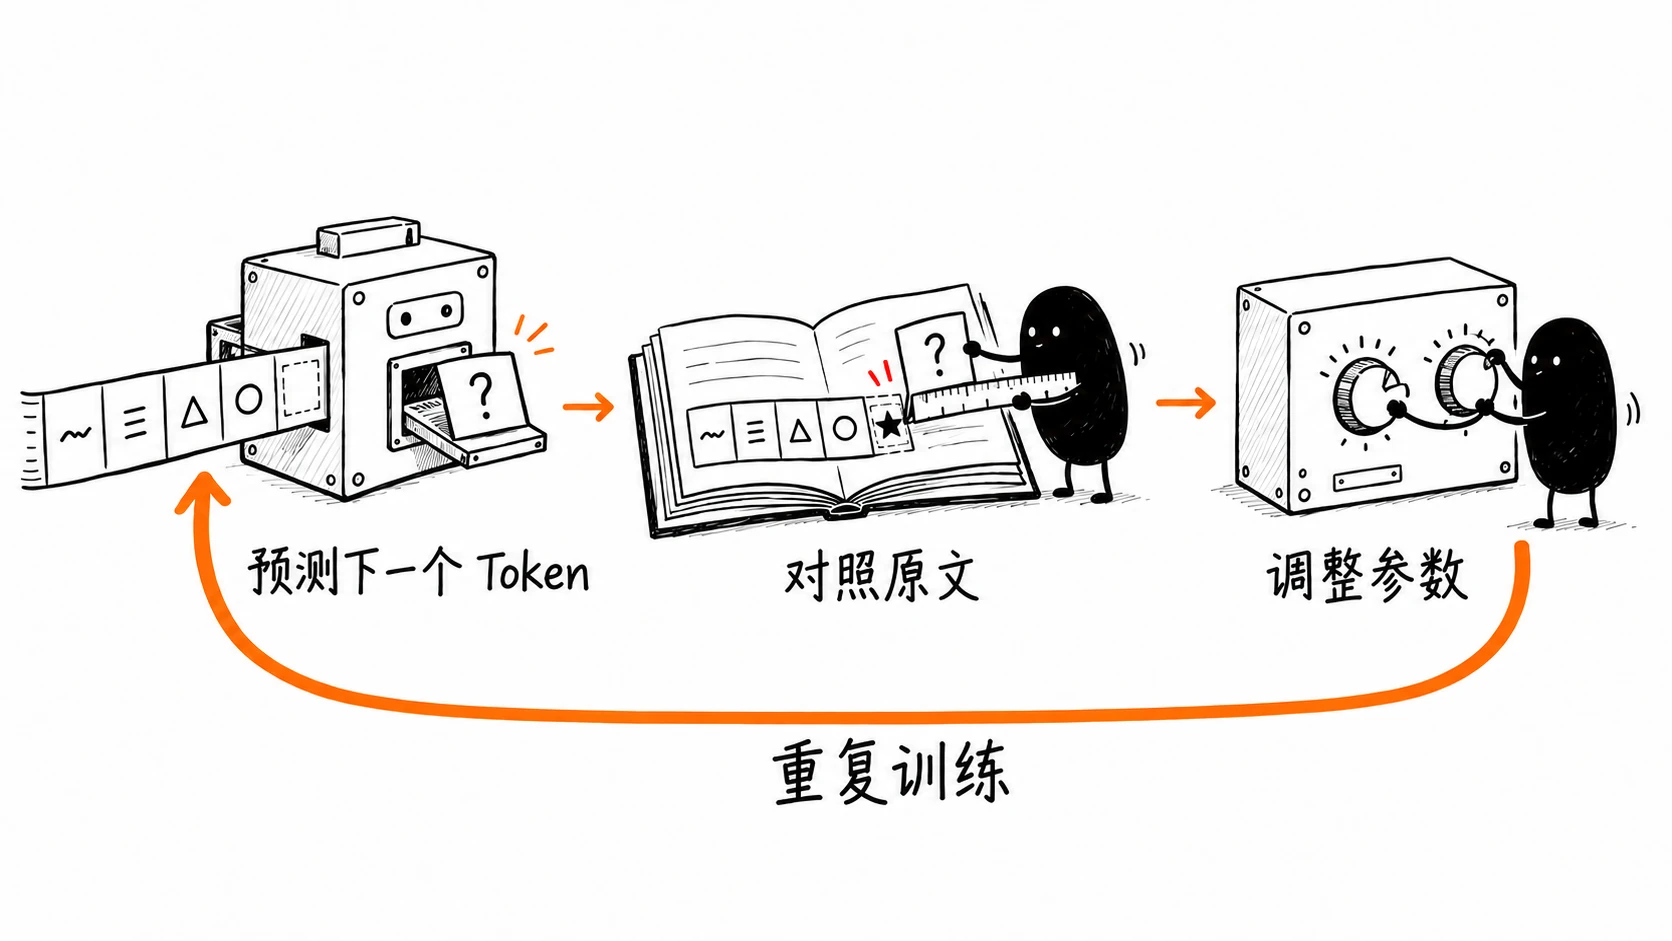
预训练会让模型从大量文本中学习语言的规律。简单来说,这个过程分成如下三步:
二、如何进行预训练?

预训练的过程大概是这样的。
第 0 步:先初始化一些参数。
我们继续拿前面讲过的公式来解释分数 = a × 输入 + b。
训练开始时,a 和 b 还没有学好,所以先给它们设置一些初始值。每个候选都有自己的 a、b,比如「伞」的初始参数是 a = 0.50、b = 1.10。这一步只是初始化,还没有根据输入计算分数或概率。
第 1 步:模型会先看一段文字,然后预测下一个 Token。
然后模型会根据初始参数,看一段文字,再预测下一个 Token。比如输入的是「今天雨天,出门记得带…」。
在这个简化例子里,我们把「下雨」作为输入 x = 1。三个候选使用同一个输入,各自的参数不同,所以会得到不同的分数。
再经过 Softmax,把分数换算为总和等于 100% 的概率。
| 候选 | 分数计算 | 分数 | Softmax 概率 |
|---|---|---|---|
| 伞 | 0.50 × 1 + 1.10 | 1.60 | 约 24.78% |
| 雨衣 | 1.00 × 1 + 1.08 | 2.08 | 约 40.05% |
| 帽子 | 0.80 × 1 + 1.15 | 1.95 | 约 35.17% |
第 2 步:模型会查看正确答案。
模型会查看训练数据中的原文——「今天雨天,出门记得带伞」。正确答案是「伞」。
第 3 步:调整参数。
看到正确答案后,模型会对参数进行调整。
之前预测的结果是「雨衣」的预测概率最高,约为 40%,而正确答案「伞」的预测概率却只有约 25%。有较大的偏差,接着训练程序会根据正确答案衡量这次预测的差距,再调整参数,让「伞」在这个输入下的预测概率提高。
比如,将「伞」的参数调整为 a = 0.60、b = 1.20,同时调整其他候选的参数。输入仍是 x = 1,得到下面这些分数和概率:
| 候选 | 分数计算 | 分数 | Softmax 概率 |
|---|---|---|---|
| 伞 | 0.60 × 1 + 1.20 | 1.80 | 约 44.95% |
| 雨衣 | 0.40 × 1 + 1.00 | 1.40 | 约 30.13% |
| 帽子 | 0.30 × 1 + 0.91 | 1.21 | 约 24.92% |
输入没有变,改变的是参数和各候选的分数。在这次调整后,「伞」的预测概率从约 25% 提高到了约 45%。
以下是整个过程的示意图:
- 00初始化
- 01预测
- 02对照
- 03调参数
第 4 步:重复预测、对照和调参数。
初始化只在训练开始时进行一次。接下来反复预测、对照原文、根据差距调整参数,而不是每一轮都重新设置初始值。
整个调整过程并不会一步到位,需要重复很多次。下面的演示继续使用同一个输入,观察「伞」的预测概率如何随训练轮次变化。
- 训练前25%
- 第 1 轮后—
- 第 2 轮后—
- 第 3 轮后—
经过多轮训练后,模型学到了语言的统计规律,能生成语法通顺、上下文连贯的文字。它可以理解文字的意思,并且可以生成符合语法和逻辑的文字。此时就能得到一个基础模型(Base Model)。
三、搞懂这个概念有什么用?
这里需要注意一个很重要的概念:模型的训练数据是有时间限制的。
换句话说,模型只能回答训练数据截止时间之前的问题。在不使用其他工具的情况下,它无法获取训练数据之外的信息。比如 GPT-6 的训练数据截止到 2026 年 4 月,所以它无法知道 4 月以后发生的事情。
第二个很重要的概念是:训练时的「正确答案」,不等于事实正确。
前面说「模型会查看正确答案」,这里的答案其实是训练数据中的下一个 Token。原文可能包含错误、偏见,或者虚构内容;预测对了原文,不代表学到的内容都符合事实。
比如,如果训练数据里全部都是「一周有六天」,那么模型就会认为一周有六天。