

Comment les modèles voient-ils les images et entendent-ils les sons ?
Comprendre les modèles multimodaux grâce aux représentations numériques et aux encodeurs. Distinguer vision, lecture, transcription et compréhension audio, puis vérifier les résultats.
Jusqu’ici, nous avons parlé de texte : vous entrez du texte et le modèle en génère. Mais certains produits d’IA permettent maintenant d’envoyer des captures d’écran, des photos ou des enregistrements, puis de poser des questions à leur sujet.
Vous vous demandez peut-être : le texte passe par un tokenizer et devient des nombres que le modèle peut traiter. Comment une photo ou un enregistrement entre-t-il dans le modèle ?
Le point de départ est le même : transformer différentes formes d’information en représentations numériques sur lesquelles le modèle peut calculer.
1. Que signifie multimodal ?
Une modalité est une forme d’information. Le texte, l’image et l’audio sont des modalités différentes. Un modèle multimodal peut en traiter plusieurs. Il peut, par exemple, recevoir une image avec du texte et produire une réponse écrite.
| Fonction visible | Capacité concernée |
|---|---|
| Envoyer une photo et demander ce qu’elle contient | Entrée image et sortie texte |
| Envoyer un enregistrement et résumer les paroles | Reconnaissance vocale, ou compréhension audio et sortie texte |
| Saisir un texte et le faire lire à voix haute | Génération vocale |
| Envoyer une photo et demander une autre image | Compréhension d’image, puis génération ou retouche d’image |
Ces capacités peuvent venir d’un seul modèle ou de plusieurs modèles qui coopèrent dans le produit. Par exemple, une fonction de saisie vocale peut d’abord transcrire l’enregistrement, puis transmettre le texte au modèle de langage.
La présence d’une saisie vocale ne prouve donc pas que le modèle de langage traite directement les sons.
2. Comment un modèle voit-il une image ?
Supposons que vous envoyiez une capture d’écran avec la question : « Que dit le bouton en bas à droite ? » Le processus comporte trois étapes :
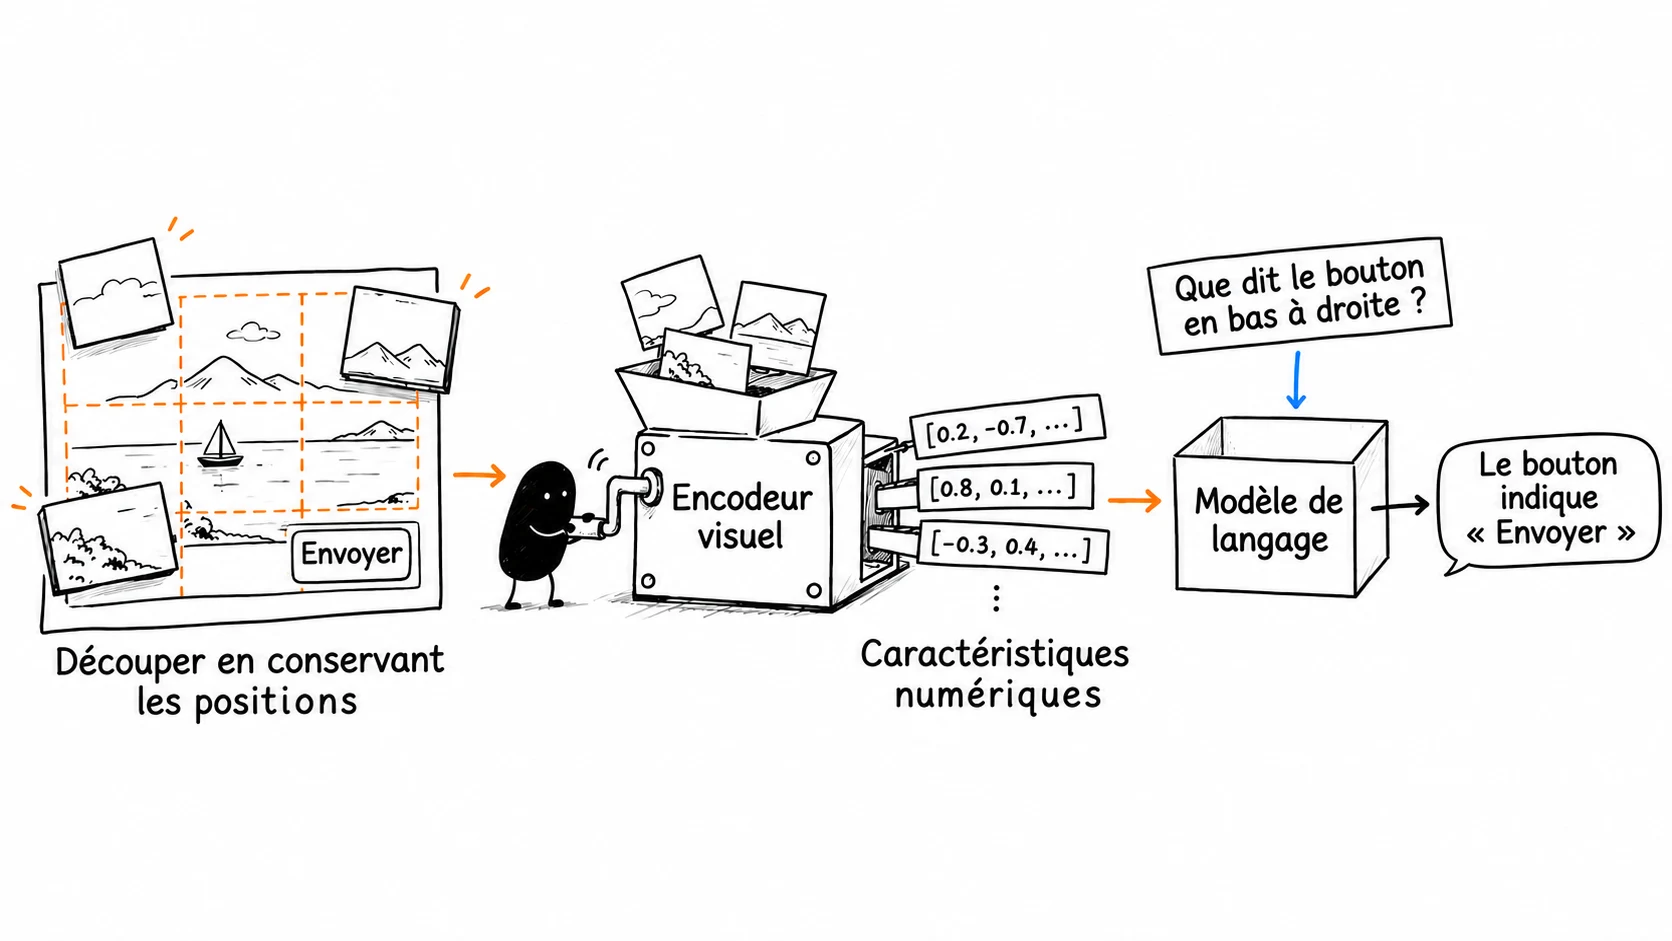
Étape 1 : traiter l’image et la diviser en régions adaptées.
Le modèle découpe d’abord la capture en petits fragments, ou patches. Il conserve aussi leur position : par exemple, le premier est en haut à gauche et le deuxième en haut à droite. Ces fragments servent d’analogie pour comprendre le processus ; tous les modèles ne découpent pas les images de la même façon.
Étape 2 : convertir l’image en représentations numériques avec un encodeur visuel.
Comme le tokenizer pour le texte, l’encodeur visuel convertit les couleurs, contours, formes et autres informations visuelles en caractéristiques numériques que le modèle peut comprendre.
Étape 3 : continuer à prédire la suite.
Après avoir reçu l’image et le texte tokenisé, le modèle prédit à nouveau le prochain token probable.

3. Comment un modèle entend-il un son ?
Comme une image, le son peut passer par un encodeur et devenir des groupes de valeurs que le modèle peut traiter.
Mais les fonctions vocales courantes peuvent suivre des chemins différents.
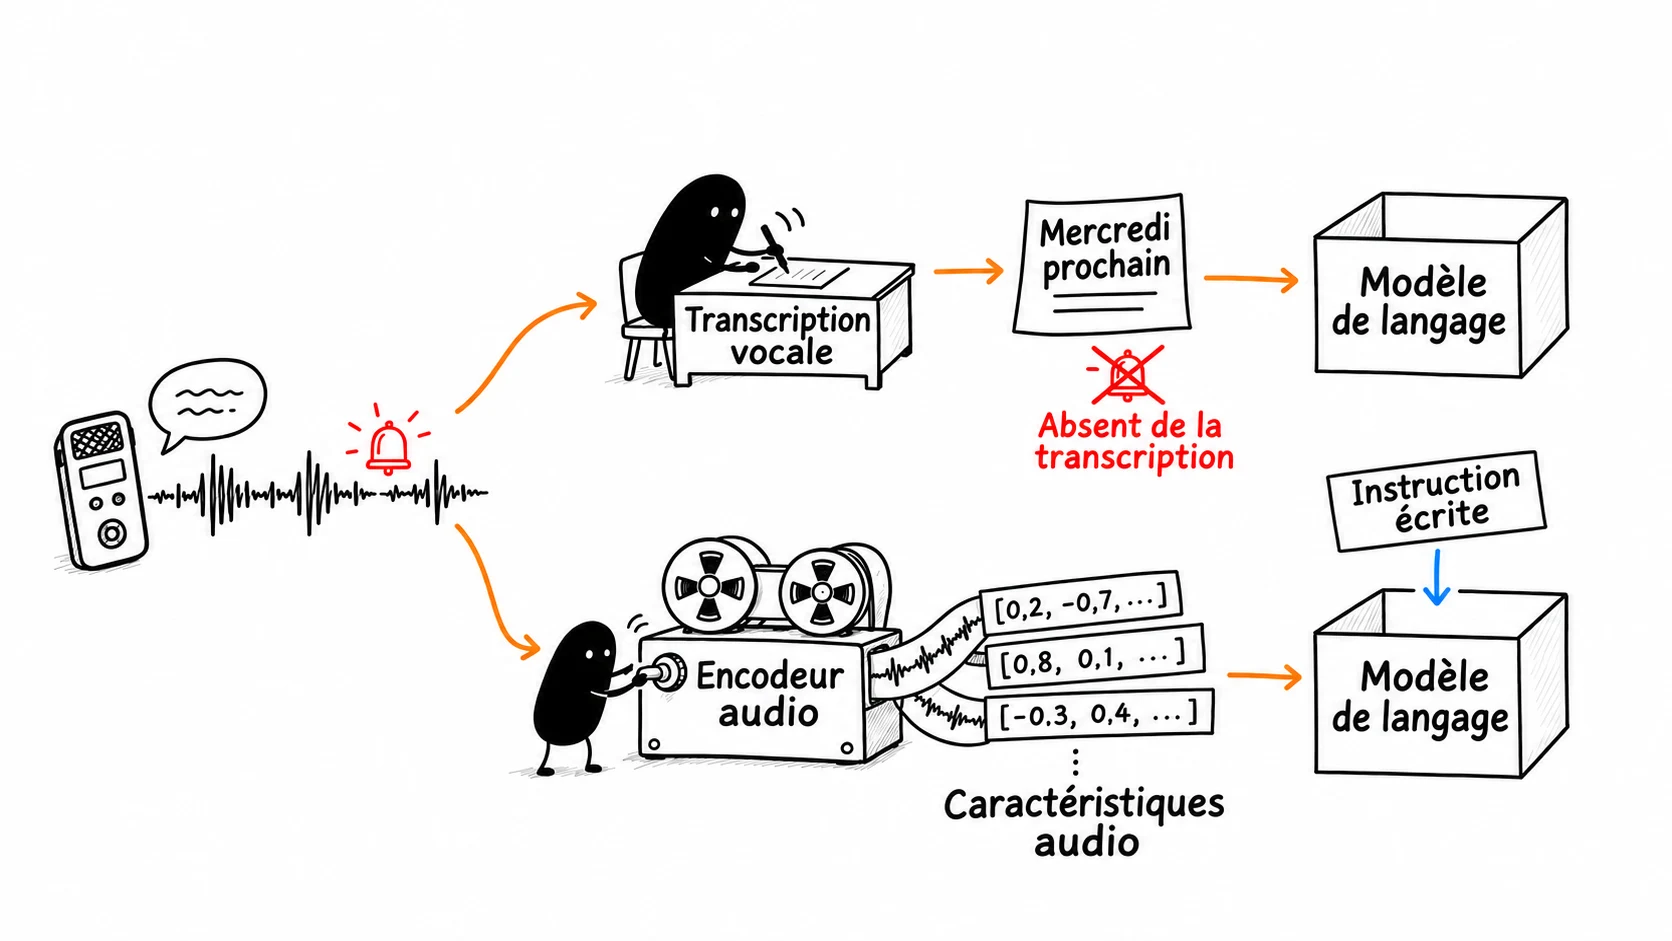
Chemin 1 : transcrire la parole, puis faire répondre le modèle de langage
Le processus est simple. Une technologie ou un modèle spécialisé convertit les paroles en texte, puis transmet ce texte au grand modèle de langage.
Celui-ci reçoit uniquement la transcription. D’autres informations peuvent disparaître : bruits de fond, pauses, ton ou variations d’émotion.
Chemin 2 : transmettre les caractéristiques audio au modèle
Une autre méthode fait passer l’audio par un encodeur, puis transmet ses caractéristiques et une consigne écrite au modèle. Celui-ci peut traiter les paroles et, selon ses capacités, les bruits de fond ou la musique.
Recevoir des caractéristiques audio ne signifie pas automatiquement savoir générer de la parole. La compréhension et la production du son peuvent relever de modèles différents.