

模型是如何看图和听声音的?
从数字表示与编码器理解多模态,区分看图、识字、语音转写和音频理解,并学会检查识别结果。
前面我们一直在讲文字:输入文字,模型生成文字。但现在,你也可以给一些 AI 产品上传截图、照片或录音,再让它们回答问题。
这时你可能会想:文字会经过 Tokenizer,变成模型能处理的数字;那一张照片、一段声音,又是怎么进入模型的?
这一讲,我们从同一个思路出发:让不同形式的信息,变成模型可以计算的数字表示。
一、什么是多模态?
我们时常听说的「多模态」里的「模态」,可以先理解为信息的形式。文字、图片和音频,就是不同的模态。那就意味着,多模态模型能够处理不止一种形式的信息。例如,同时接收图片和文字,再生成文字回答。
| 你看到的功能 | 涉及什么能力? |
|---|---|
| 上传照片,询问照片里有什么 | 图片输入与文字输出 |
| 上传录音,整理讲话内容 | 语音识别,或音频理解与文字输出 |
| 输入文字,让产品念出来 | 语音生成 |
| 上传照片,让产品生成另一张图 | 图片理解,以及图像生成或编辑 |
这些能力可能由一个模型完成,也可能由产品里的多个模型配合完成。比如,先把录音转成文字,再交给语言模型整理,就能做出语音输入功能。
因此,看到产品提供语音输入功能,并不能据此判断它背后的语言模型可以直接处理声音。
二、模型是如何看图的?
假设你上传了一张截图,并问模型:「这张图右下角的按钮上写了什么?」此时会经历以下三个步骤:
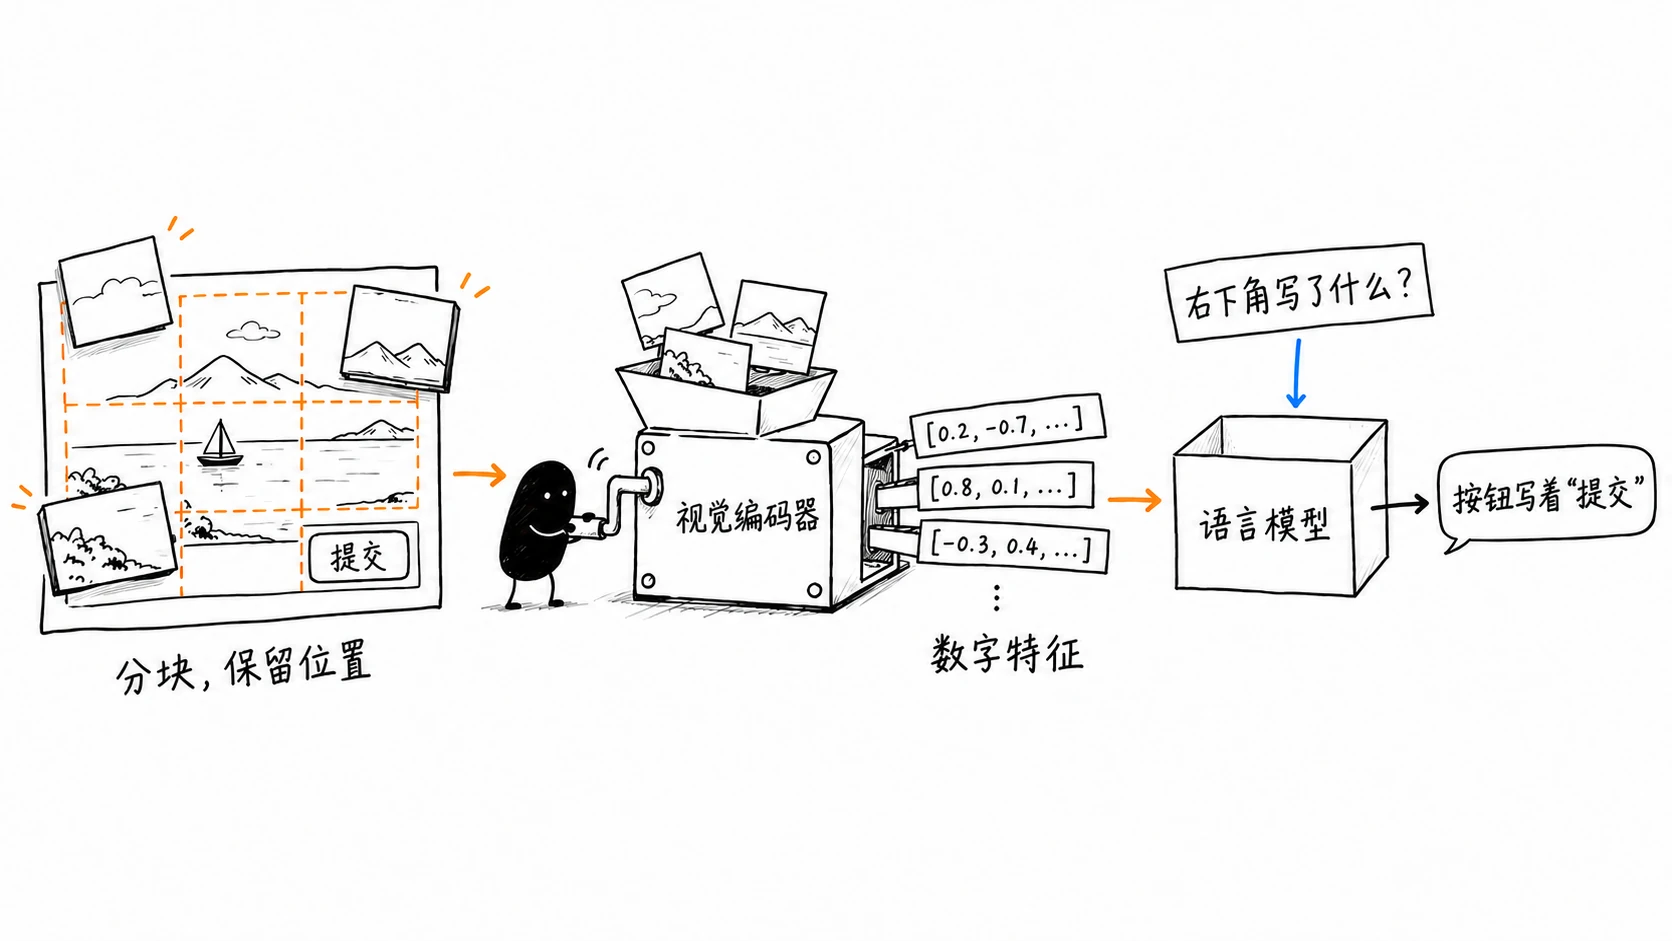
第一步:处理图片,将它划分成适合计算的区域。
首先,模型会把一张界面截图分成许多小块。同时还会记录与切块位置相关的信息,比如第一块是左上角,第二块是右上角,以此类推。(注意:这里的小块只是帮助理解的类比,并不是说每个模型都会采用相同的切法。)
第二步:通过视觉编码器,把图片变成一组数字表示。
与文本的 Tokenizer 类似,第二步,视觉编码器会把图片的颜色、边缘、形状等视觉信息转换成模型能够理解的数字特征。
第三步:其实还是一样的接龙。
接收到图片和文字 Token 化后的数据后,模型又跟之前一样,猜测下一个可能的 Token 是什么。

三、模型是如何听声音的?
声音也可以类似图片那样,通过编码器,变成模型能处理的一组组数值。
不过,在产品里常见的语音功能,可能走不同的路径。
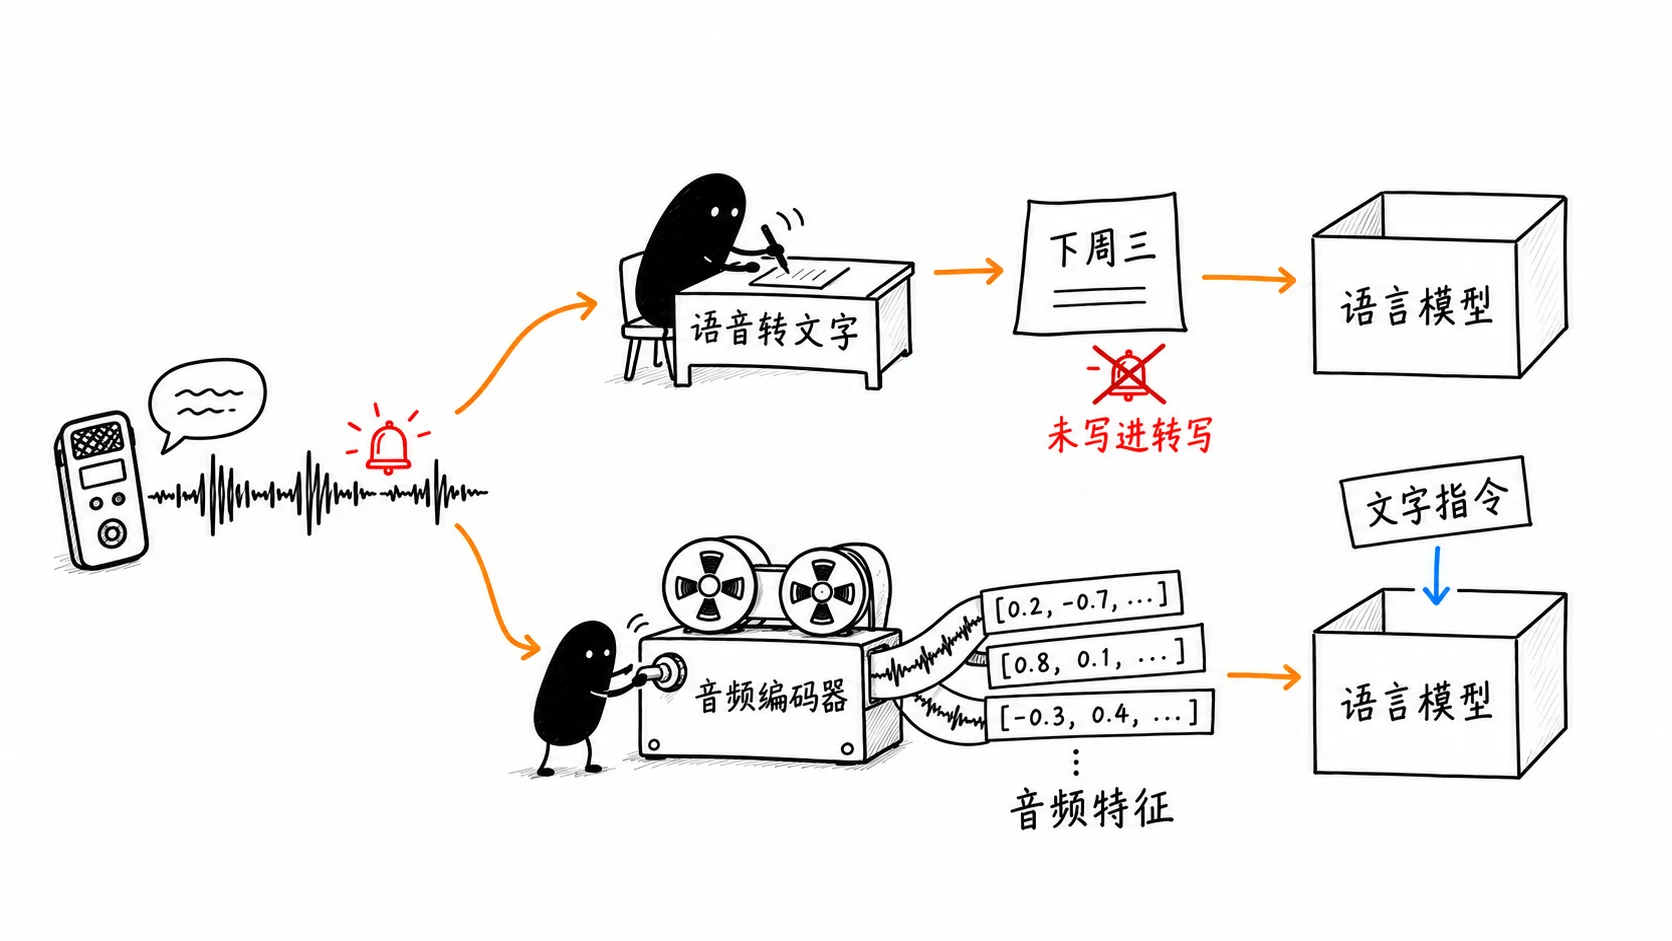
路径一:先转成文字,再让语言模型回答
这个过程很简单,就是使用一个专门的声音转文字的技术(或模型)将录音中的讲话转化为文字,然后再将文字发送给大语言模型处理。
但这种方案里,大语言模型只收到转写的文字,会缺失一些除了文字之外的信息,比如背景音、说话的停顿和语调,或者情绪变化等。
路径二:让模型接收音频特征
另一类方案会让音频经过编码器,再把音频特征与文字指令一起交给模型。它可以处理讲话内容,也可能处理背景声音、音乐等信息,具体取决于模型的能力。
还需要注意,能接收音频特征,并不自动意味着能生成语音。理解声音和生成声音很可能是不同的模型完成的。