

¿Cómo ven imágenes y oyen sonidos los modelos?
Entiende los modelos multimodales mediante representaciones numéricas y codificadores. Distingue imágenes, lectura, transcripción y comprensión de audio, y aprende a comprobar los resultados.
Hasta ahora hemos hablado de texto: introduces texto y el modelo genera texto. Pero algunos productos de IA ya permiten subir capturas de pantalla, fotos o grabaciones y hacer preguntas sobre ellas.
Quizá te preguntes: el texto pasa por un tokenizador y se convierte en números que el modelo puede procesar. ¿Cómo entra una foto o una grabación en el modelo?
Partimos de la misma idea: convertir distintas formas de información en representaciones numéricas con las que el modelo puede calcular.
1. ¿Qué significa multimodal?
Una modalidad es una forma de información. El texto, las imágenes y el audio son modalidades diferentes. Un modelo multimodal puede trabajar con más de una. Por ejemplo, puede recibir una imagen junto con texto y generar una respuesta escrita.
| Función visible | Capacidad implicada |
|---|---|
| Subir una foto y preguntar qué contiene | Entrada de imagen y salida de texto |
| Subir una grabación y resumir lo hablado | Reconocimiento de voz, o comprensión de audio y salida de texto |
| Introducir texto y hacer que el producto lo lea en voz alta | Generación de voz |
| Subir una foto y pedir otra imagen | Comprensión de imágenes, más generación o edición de imágenes |
Estas capacidades pueden pertenecer a un modelo o a varios que colaboran dentro del producto. Por ejemplo, una función de entrada de voz puede transcribir primero la grabación y enviar ese texto al modelo de lenguaje.
Que exista una función de voz no demuestra por sí solo que el modelo de lenguaje procese sonido directamente.
2. ¿Cómo ve una imagen un modelo?
Supón que subes una captura y preguntas: «¿Qué dice el botón de la esquina inferior derecha?». El proceso tiene tres pasos:
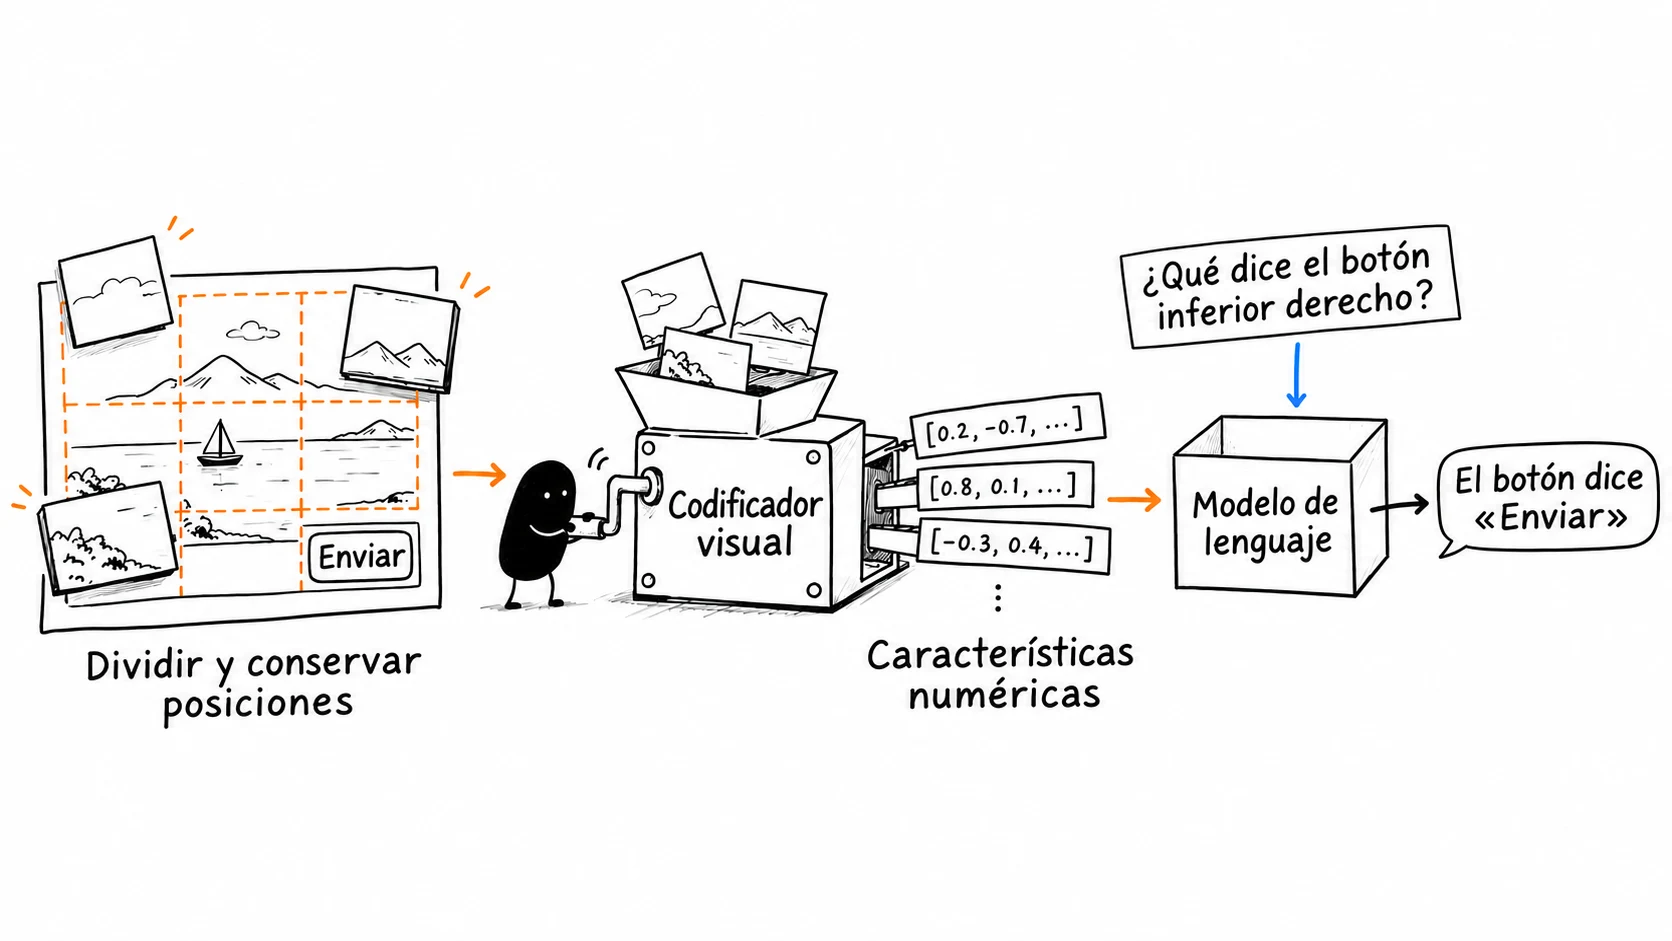
Paso 1: procesar la imagen y dividirla en regiones adecuadas.
Primero, el modelo divide la captura en pequeños fragmentos, o parches. También registra sus posiciones: por ejemplo, el primero está arriba a la izquierda y el segundo arriba a la derecha. Los parches son una analogía para explicar el proceso; no todos los modelos dividen las imágenes igual.
Paso 2: convertir la imagen en representaciones numéricas mediante un codificador visual.
Como el tokenizador para el texto, el codificador visual convierte colores, bordes, formas y otra información visual en características numéricas que el modelo puede comprender.
Paso 3: seguir prediciendo lo que viene después.
Tras recibir la imagen y el texto tokenizado, el modelo vuelve a predecir el siguiente token probable.

3. ¿Cómo oye un sonido un modelo?
Igual que una imagen, el sonido puede pasar por un codificador y convertirse en grupos de valores que el modelo puede procesar.
Pero las funciones de voz habituales pueden seguir caminos distintos.
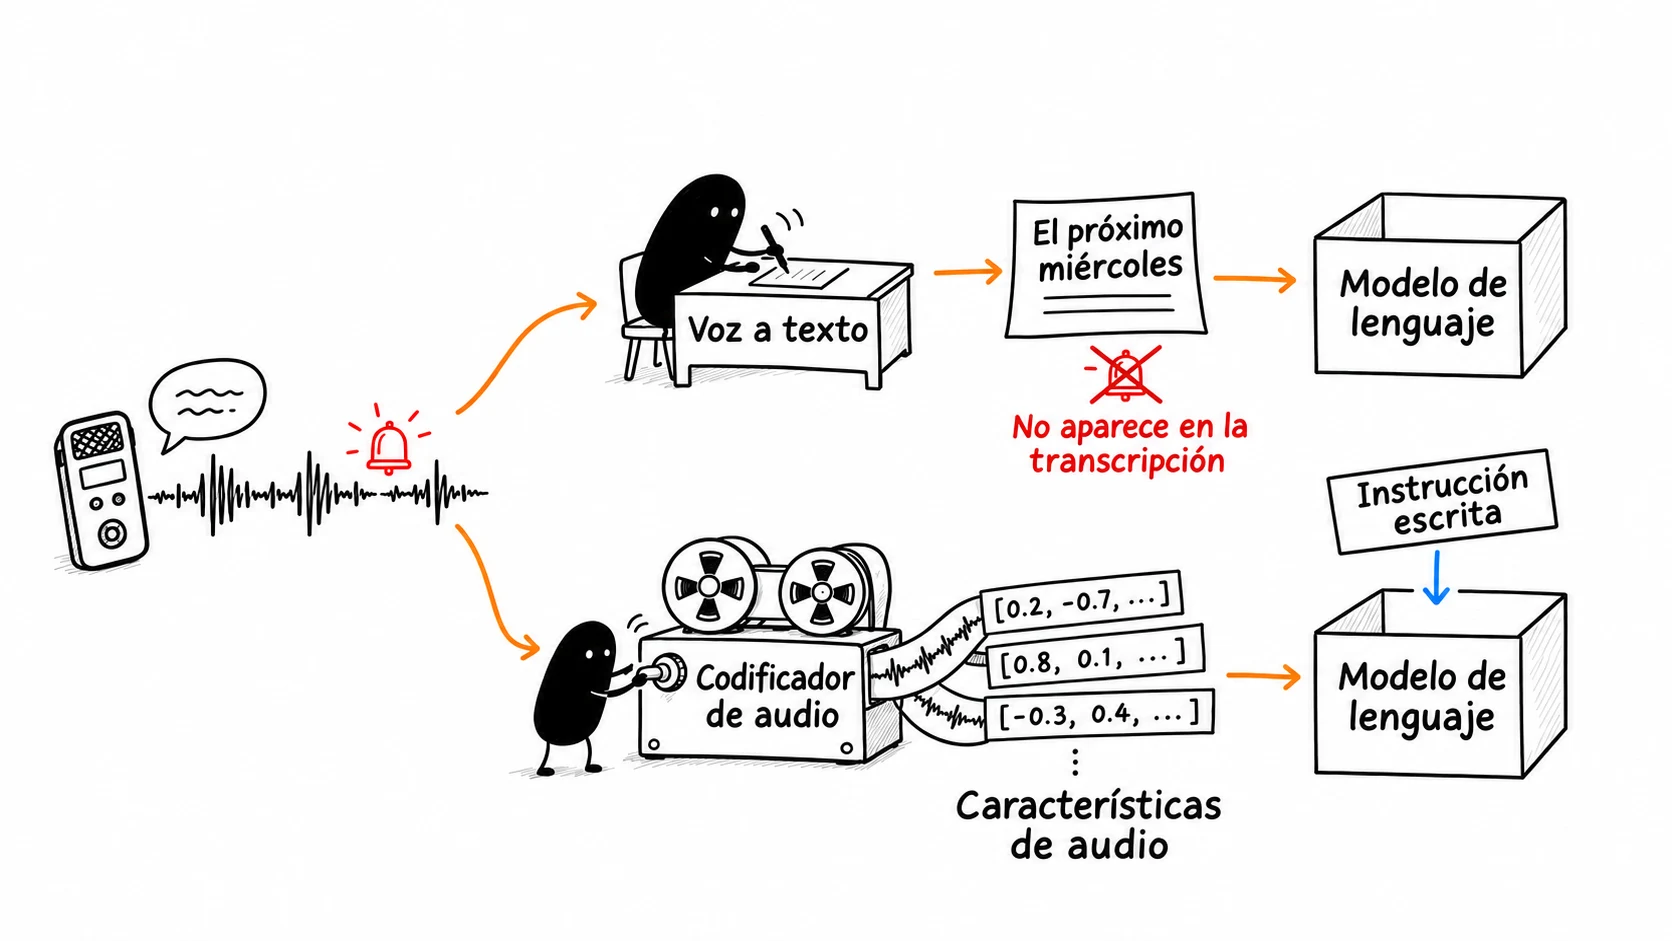
Camino 1: transcribir la voz y dejar que responda el modelo de lenguaje
El proceso es sencillo. Una tecnología o un modelo especializado convierte las palabras habladas en texto y envía ese texto al gran modelo de lenguaje.
Aquí, el modelo solo recibe la transcripción. Puede perderse otra información, como los sonidos de fondo, las pausas, el tono o los cambios de emoción.
Camino 2: permitir que el modelo reciba características de audio
Otro método pasa el audio por un codificador y envía sus características junto con una instrucción escrita al modelo. Este puede procesar el habla y, según sus capacidades, también los sonidos de fondo o la música.
Recibir características de audio no significa automáticamente que el modelo pueda generar voz. Comprender sonidos y producirlos pueden ser funciones de modelos distintos.